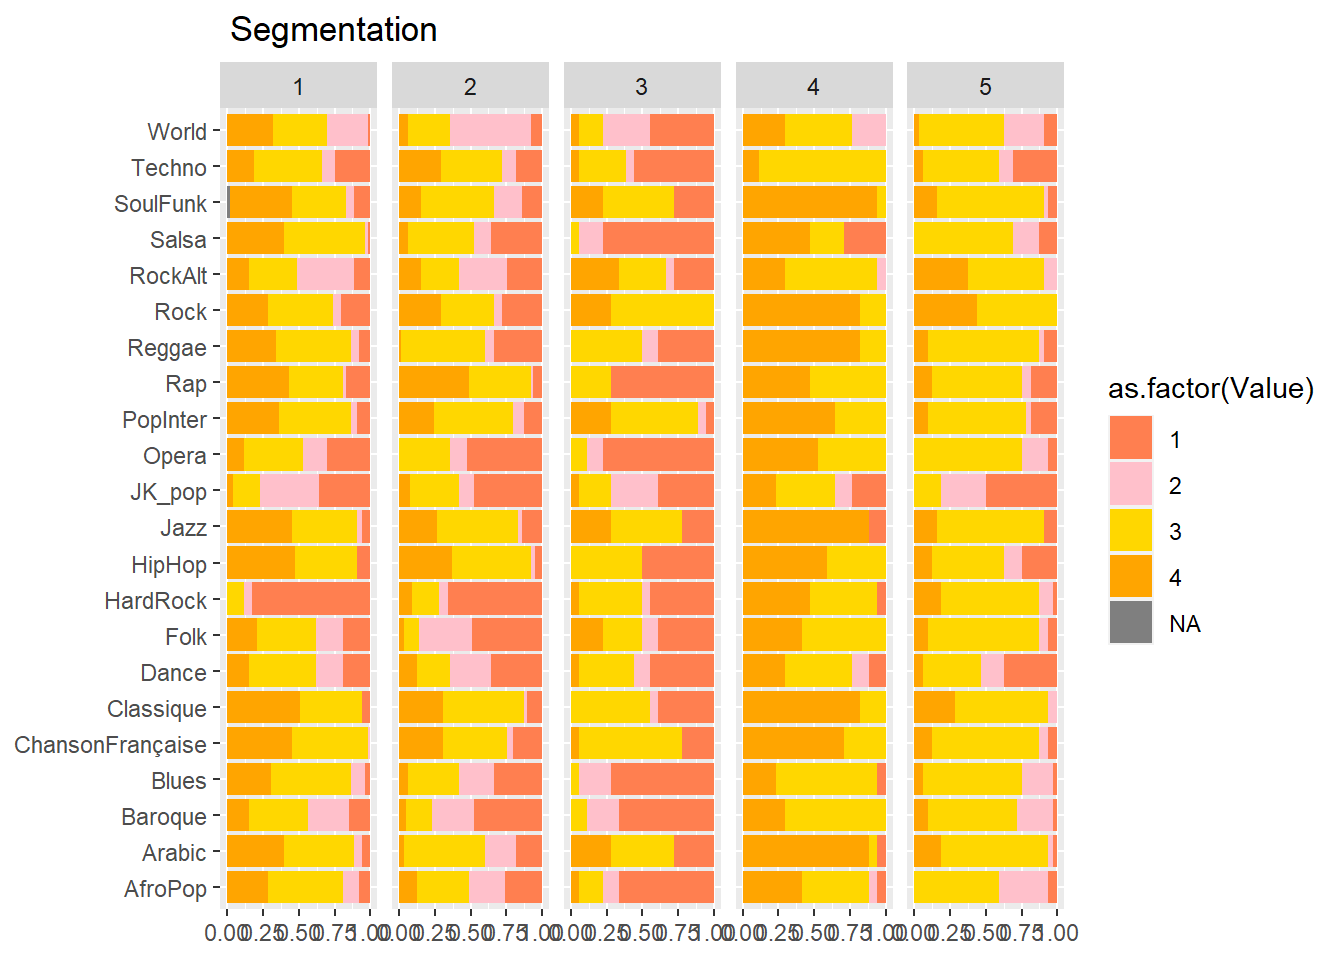
library(tidyverse)df <-read_csv("Plateformes3.csv")%>%rename(ID=1,Rock=2,PopInter=3,HipHop=4,World=5,Salsa=6,Classique=7,Techno=8,HardRock=9,Baroque=10,Folk=11,Reggae=12, ChansonFrançaise=13,RockAlt=14,Dance=15,Jazz=16,AfroPop=17,Opera=18,Arabic=19,Blues=20,JK_pop=21,Rap=22,SoulFunk=23,S_travail=24,S_Live=25,S_Voiture=26,S_Menage=27,S_Ami=28,S_Bars=29,S_Transport=30,S_Lire=31,S_Douche=32,D_Vynil=33,D_Streaming=34,D_smartphone=35,D_concert=36,D_laptop=37,D_ecouteurs=38,D_mix=39,D_radiotv=40,P_Youtube=42,P_Spotify=43,P_Deezer=44,P_Souncloud=45,P_Bandcamp=46, P_Discog=47,P_Tidal=48,P_Amazon=49,P_Mixcloud=50,P_AppleM=51,P_Qobuz=52,P_Pandora=53,P_Netease=54,Time=68,Spending=69,Value=70, Age=71,Education=72,Genre=73 )df$Age<-factor(df$Age, ordered =TRUE, levels =c("moins de 18 ans", "de 18 à 20 ans","de 21 à 25 ans", "de 26 à 30 ans","de 31 à 40 ans", "de 41 à 60 ans","plus de 60 ans"))#color palettecol<-c("Coral","Pink","Gold","Orange")
Comparaison de moyenne
Code
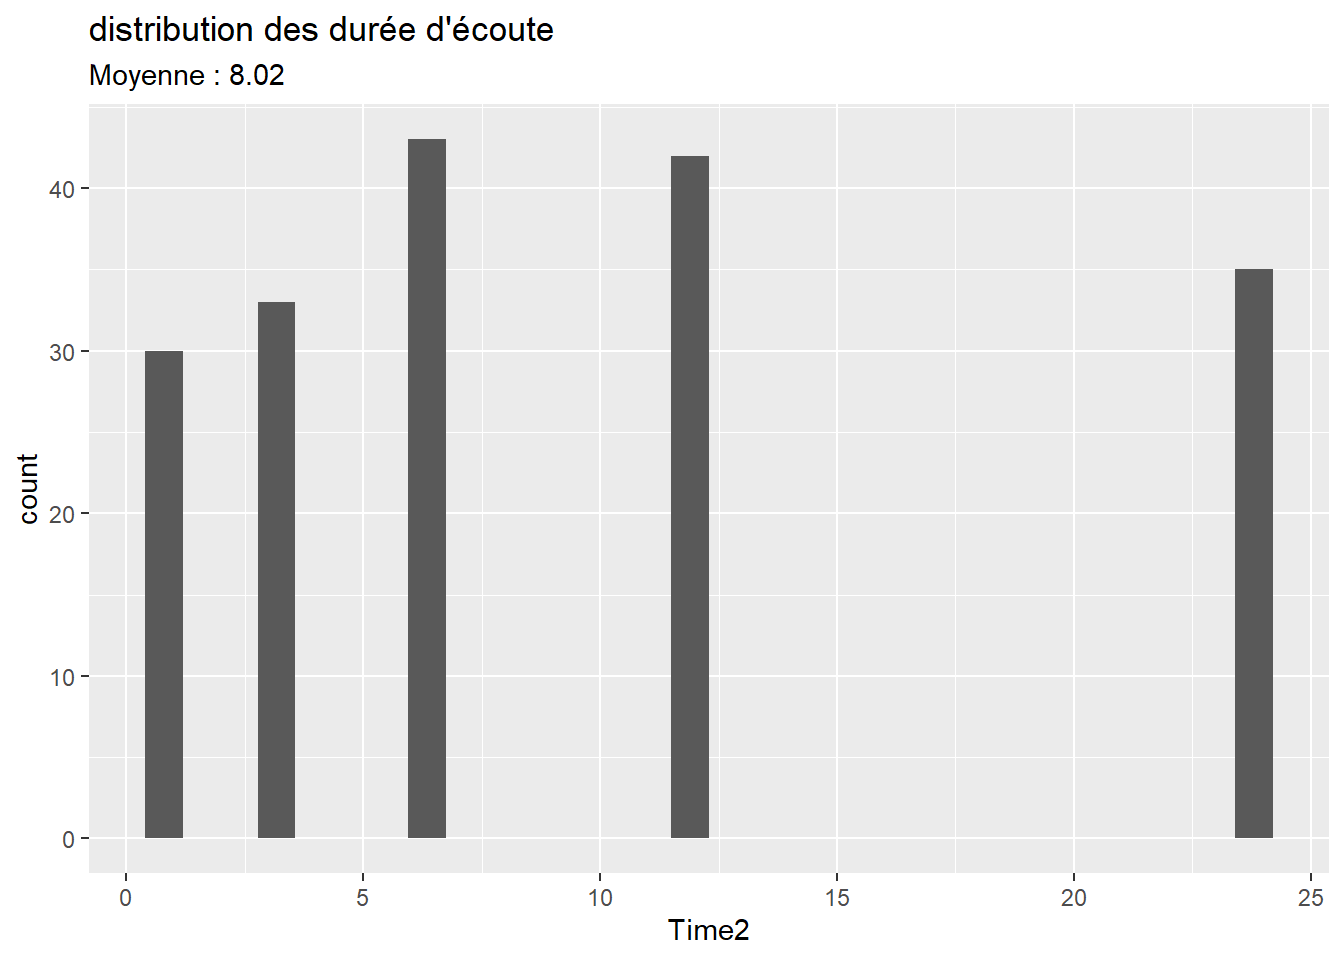
table(df$Time)
 Entre 2 et 4h  Entre 4 et 8h Entre 8 et 16h    Moins de 2h    Plus de 16h
            33             43             42             30             35
Code
df$Time2<-NAdf$Time2[df$Time=="Moins de 2h"]<-1df$Time2[df$Time=="Entre 2 et 4h"]<-3df$Time2[df$Time=="Entre 4 et 8h"]<-6df$Time2[df$Time=="Entre 8 et 16h"]<-12df$Time2[df$Time=="Plus de 16h"]<-24moyenne_time<-round(mean(df$Time2, na.rm=TRUE), 2)moyenne_time<-round(sd(df$Time2, na.rm=TRUE), 2)ggplot(df, aes(x=Time2))+geom_histogram()+labs(title ="distribution des durée d'écoute",subtitle =paste0("Moyenne : ",moyenne_time))
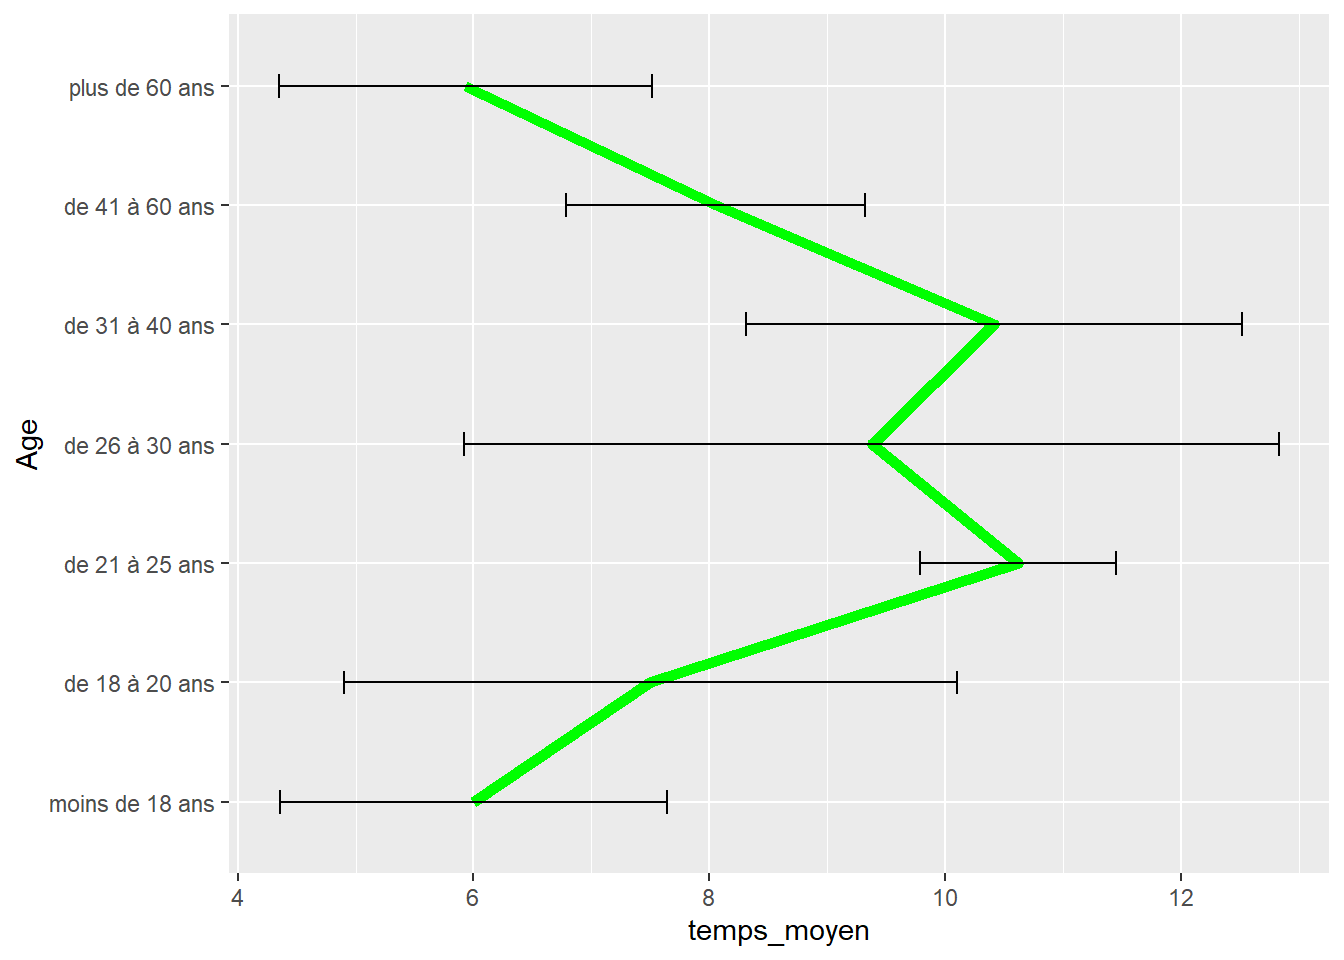
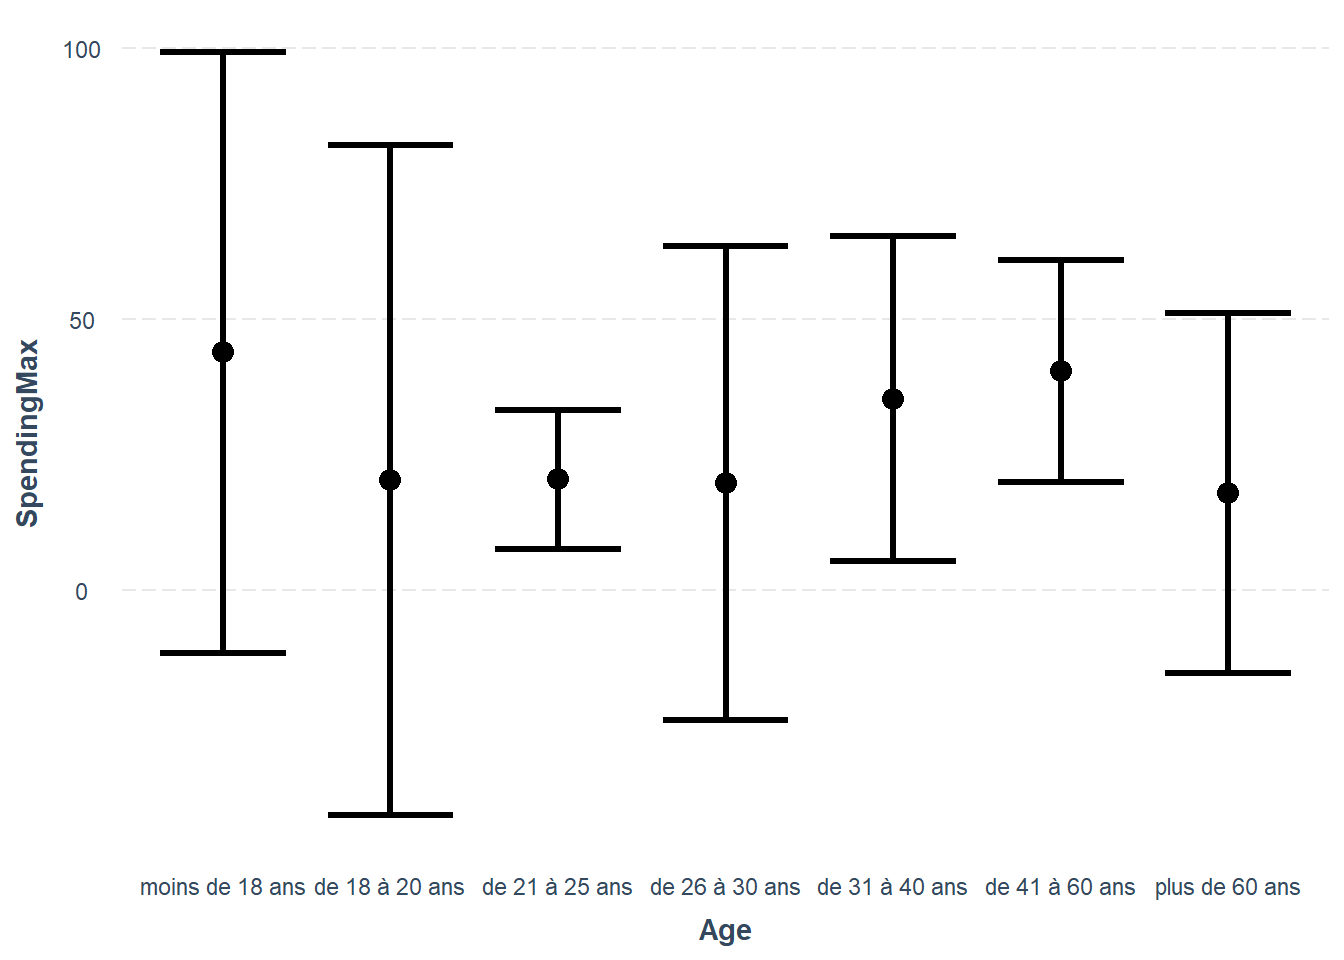
# A tibble: 7 x 5
  Age                 n temps_moyen temps_sd    sd
  <ord>           <int>       <dbl>    <dbl> <dbl>
1 moins de 18 ans     5        6        3.67 1.64
2 de 18 à 20 ans      4        7.5      5.20 2.60
3 de 21 à 25 ans     97       10.6      8.17 0.829
4 de 26 à 30 ans      8        9.38     9.77 3.45
5 de 31 à 40 ans     17       10.4      8.67 2.10
6 de 41 à 60 ans     40        8.05     8.01 1.27
7 plus de 60 ans     14        5.93     5.92 1.58
Code
fit<-lm(Time2 ~ Age,data=df)anova(fit)
Analysis of Variance Table

Response: Time2
           Df  Sum Sq Mean Sq F value Pr(>F)
Age         6   470.7  78.457  1.2286 0.2937
Residuals 176 11238.7  63.856
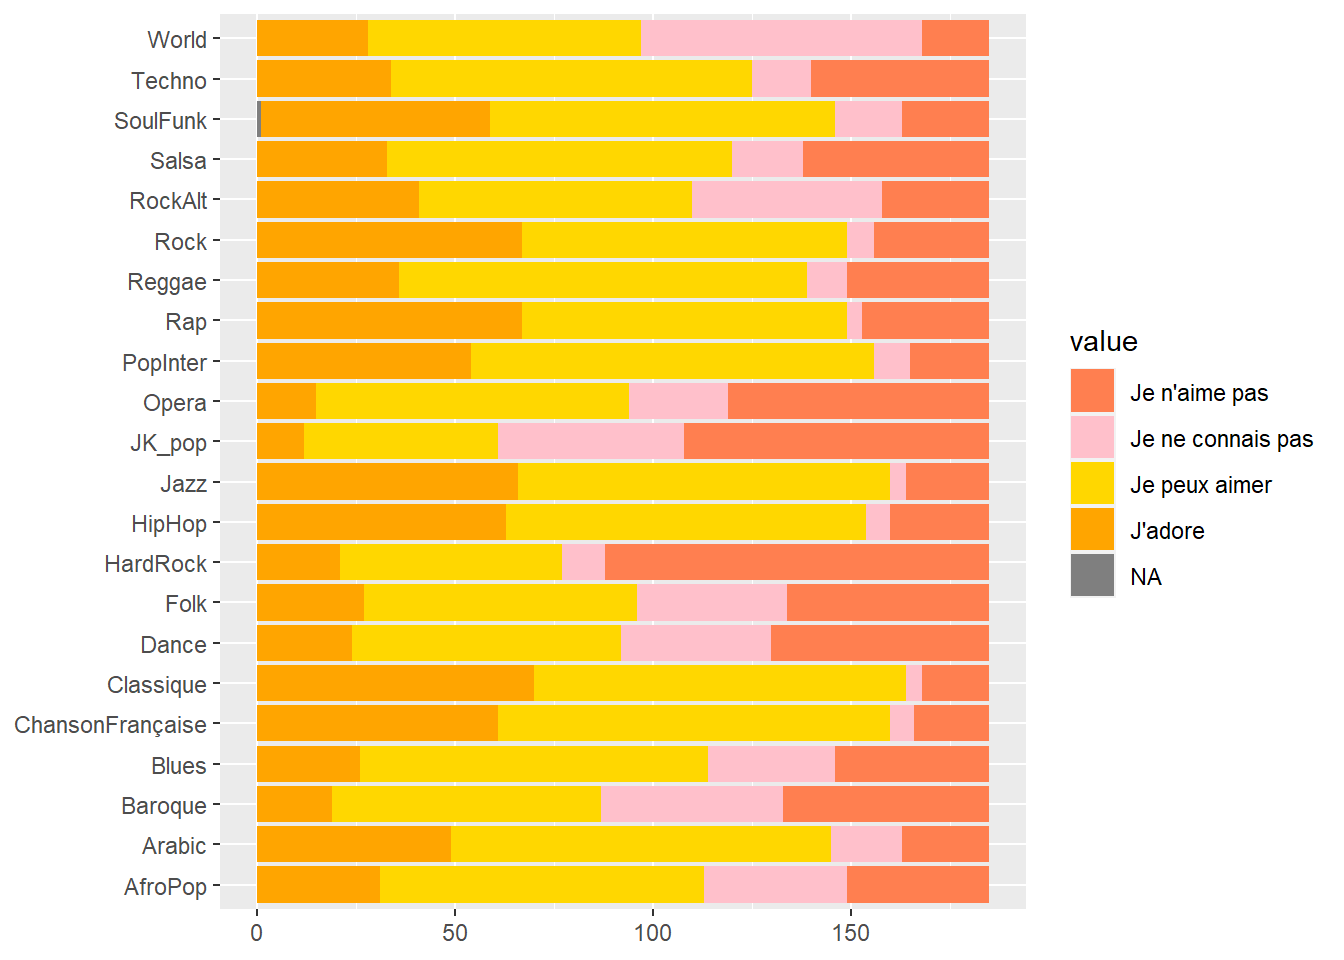
#construire le bon tableaufoo<- df %>%select(1:23) %>%pivot_longer(-ID,names_to="variable", values_to ="value")table(foo$value)
                J'adore         J'aime beaucoup          J'aime pas mal
                    895                       7                       2
J'aime pas mal, J'adore         J'aime pas trop           J'aime un peu
                      1                       3                       6
          Je n'aime pas       Je ne connais pas           Je peux aimer
                    849                     510                    1797
Code
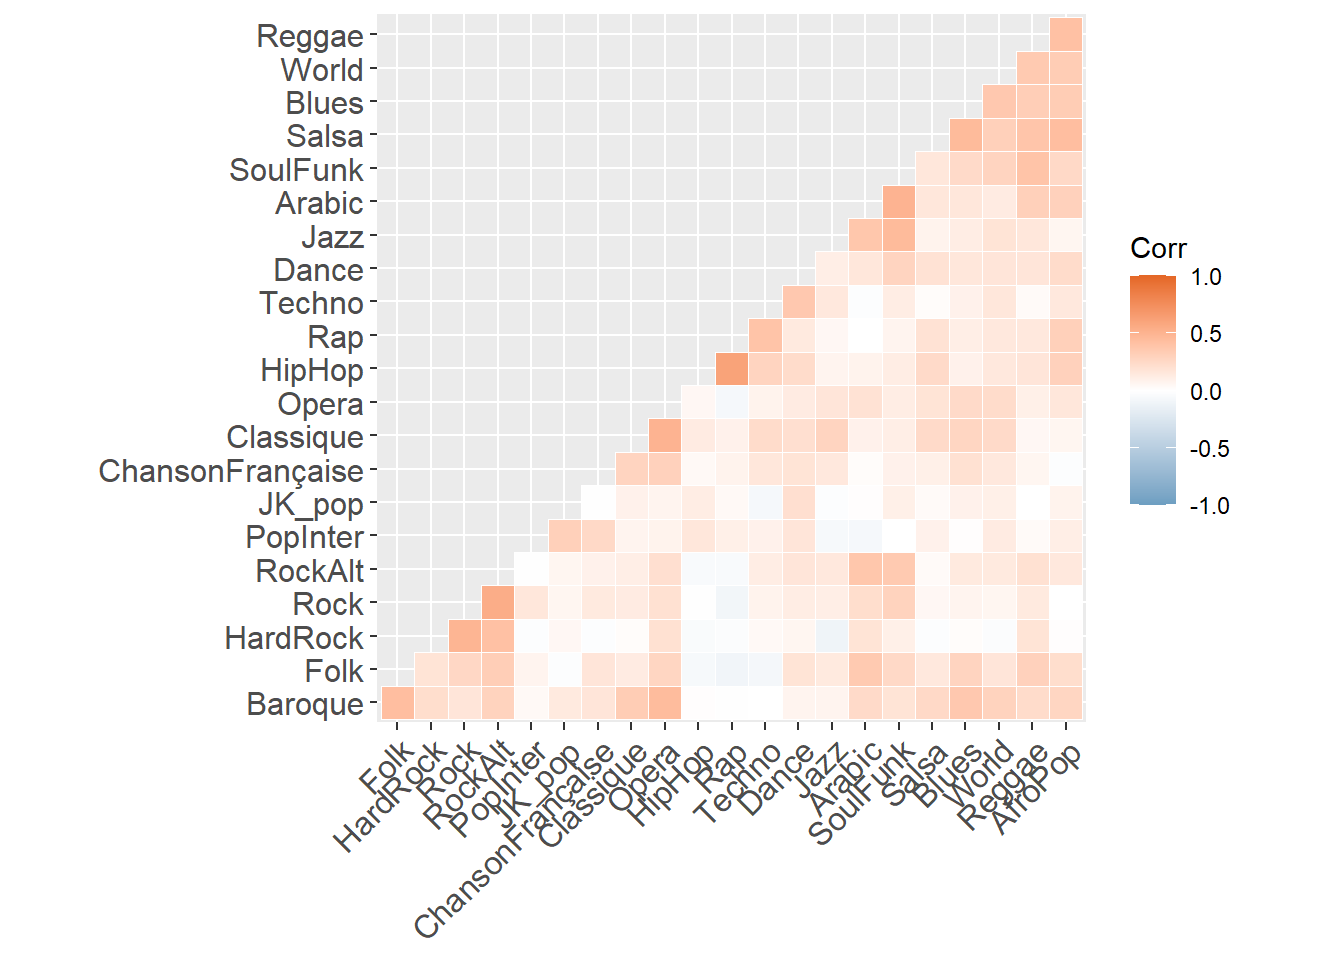
foo$value[foo$value=="J'aime beaucoup"]<-"J'adore"foo$value[foo$value=="J'aime pas mal"]<-"Je peux aimer"foo$value[foo$value=="J'aime un peu"]<-"Je peux aimer"foo$value[foo$value=="J'aime pas trop"]<-"Je n'aime pas"foo$value <-factor(foo$value, levels =c("Je n'aime pas","Je ne connais pas","Je peux aimer","J'adore"))foo$value2[foo$value=="Je n'aime pas"]<-1foo$value2[foo$value=="Je ne connais pas"]<-2foo$value2[foo$value=="Je peux aimer"]<-3foo$value2[foo$value=="J'adore"]<-4foo<-foo %>%select(-value)%>%pivot_wider(id_cols=ID,names_from ="variable", values_from ="value2")corr<-foo[,2:23]%>%drop_na()%>%cor()ggcorrplot(corr, hc.order =TRUE, type ="lower",outline.col ="white",ggtheme = ggplot2::theme_gray,colors =c("#6D9EC1", "white", "#E46726"))