PMP 40ans

Vectoriser le corpus

Author

CB MB SB

Published

June 29, 2023

Les outils

Code
library(tidyverse) #on ne peut plus s'en passer
library(quanteda) # les bases du nlp
library(quanteda.textstats)
library(quanteda.textmodels)
library(scales)
library(ggwordcloud)
library(readr) #lire les donnees
library(pals)
library(ggrepel) #gestion des labels
library(plotly)
library(doc2vec)
library(tidyr)
library(word2vec)
library(uwot)

library('extrafont') #c'est pour igraph
# Import des fontes du système - cela peut être long
#font_import()
#fonts() # Liste des polices disponibles
#loadfonts(device = "pdf") # Indiquer device = "pdf" pour produire un pdf 

theme_set(theme_minimal())

col<- c("#ca7dcc","#fb6a4a","orange","#67000d", "firebrick", "pink", "ivory3","skyblue")

Les data

Code
PMP <- read_csv("./data/PMPLast.csv")

dn<-PMP %>% 
  select(Key,`Publication Year`,Title, `Abstract Note`, Issue, Volume)%>% 
  rename(Year=`Publication Year`, Abstract=`Abstract Note`) %>% 
  mutate(text=paste0(Title,". ", Abstract),
         text=str_replace_all(text,"[.'.]"," "),
         text=str_replace_all(text,"[.’.]"," "),
         text=str_replace_all(text,"-", ""),
         text=str_replace_all(text,"[*]", ","),
         text=str_replace_all(text,"[/]", " "),
         nchar=nchar(text),
         n_words = stringr::str_count(text, ' '),
         decade=as.character(ifelse(Year<2000,(floor((Year-1900)/10)*10)+1900,(floor((Year-2000)/10)*10)+2000)),
         Issue2=ifelse(str_sub(Issue, 1,3)=="Vol",str_sub(Issue, -1),Issue), 
         Issue2=ifelse(Issue2=="1-2",1, ifelse(Issue2=="3-4",3, Issue2)),
         x=as.numeric(Issue2)/4,
         numéro=Year+x) %>%  
  filter(Abstract!="Null") #critere du résume

Une appoche par embeddings : un simple word2vec

pq ?

simple, endogène . Un bert possible mais ne reflète pas la langue dans cette revue, on écarte donc l’option de modèle préèentrainés.

Comment ?

  1. vectoriser les mots / tokens
  2. vectoriser les documents
  3. vectoriser les concepts

D’autre méthodes ? Il y en a beaucup^s un essai avec paragragh to vec

La suite est un relatif échec. On reste à l’approche la plus simple.

On utilise un modèle particulier qui est paragraph2vec. Analogie à word to vec il comprend un token supplémentaire qui est le document, vectorisé dans le même espace que celui des mots. Ce qu’on peut en attendre- résoudre simultanéement l’embeddings des termes et celui des documents - un apport d’information par l’identification du document. Mais comment çà oeuvre ?

On utilise le package Word2vec de bnozacs ( à préciser)

les étapes

Une approche de cleaning par annotation

La stratégie est de s’appuyer sur une annotation intégrale des textes.

Udpipe

Code
# On constitue le corpus et on annote
library(udpipe)
dl <- udpipe_download_model(language = "french")
udmodel<- udpipe_load_model(file = dl$file_model)
tokens0 <- udpipe_annotate(udmodel, x = dn$text, trace=100) #annotation
2023-06-29 09:46:19 Annotating text fragment 1/955
2023-06-29 09:46:56 Annotating text fragment 101/955
2023-06-29 09:47:35 Annotating text fragment 201/955
2023-06-29 09:48:15 Annotating text fragment 301/955
2023-06-29 09:48:55 Annotating text fragment 401/955
2023-06-29 09:49:38 Annotating text fragment 501/955
2023-06-29 09:50:20 Annotating text fragment 601/955
2023-06-29 09:51:06 Annotating text fragment 701/955
2023-06-29 09:51:43 Annotating text fragment 801/955
2023-06-29 09:52:23 Annotating text fragment 901/955
Code
#on traite l'index
tokens<-tokens0 %>% 
  as.data.frame() %>%
  mutate(doc_id=as.numeric(str_remove(doc_id,"doc")))

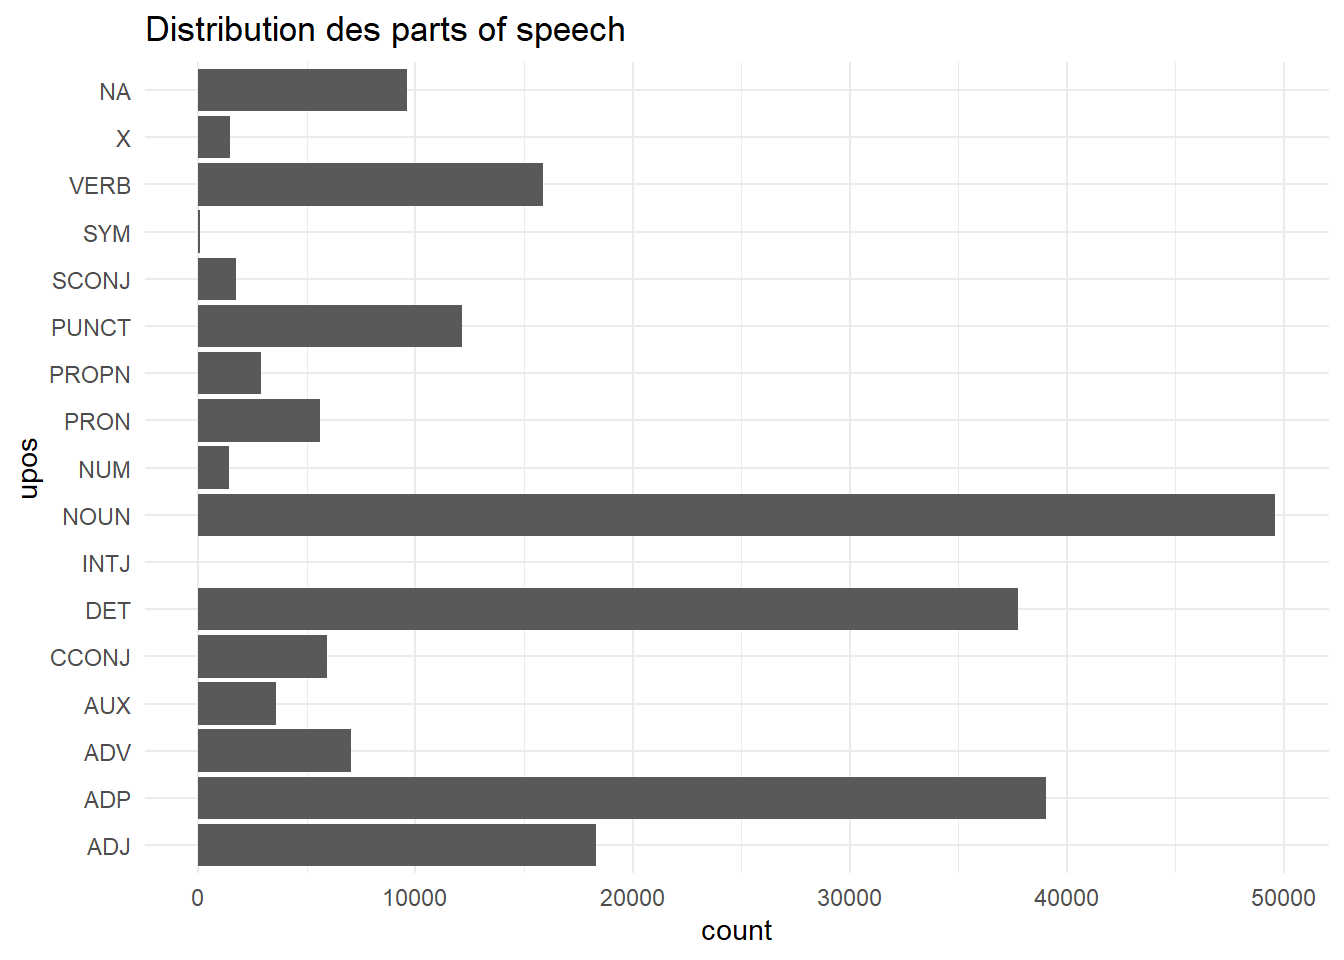
#la distribution des POS

g<- ggplot(tokens, aes(x=upos))+
  geom_bar()+
  coord_flip()+
  labs(title = "Distribution des parts of speech")
g

Code
ggsave("./images/pos01.jpeg", plot=g , width = 27, height = 18, units = "cm")

On manipule les données pour construire un dictionnaire quantitatif

Code
#on matche à key et on content le nombre de token par document
doc <- tokens %>%
  group_by(doc_id) %>%
  summarise(n_tok_doc=n()) %>%
  cbind(dn[,1])

#pour l'IDF
words_total<-as.numeric(nrow(tokens)) #nombre total de tokens dans le corpus
doc_total=as.numeric(nrow(dn))

#on calcule la frequence des lemmas/upos
tokens_lemma<-tokens %>% 
  left_join(doc)%>%
  group_by(Key,lemma)%>%
  summarise(n=n(), Key=first(Key),upos=first(upos))

tokens_lemma2<-tokens_lemma%>% 
    group_by(lemma)%>%
  summarise(n_doc=n(), 
            upos=first(upos),
            frequency=sum(n),
            tf= frequency/words_total,
            idf=log(doc_total/n_doc),
            tfidf=tf*idf)

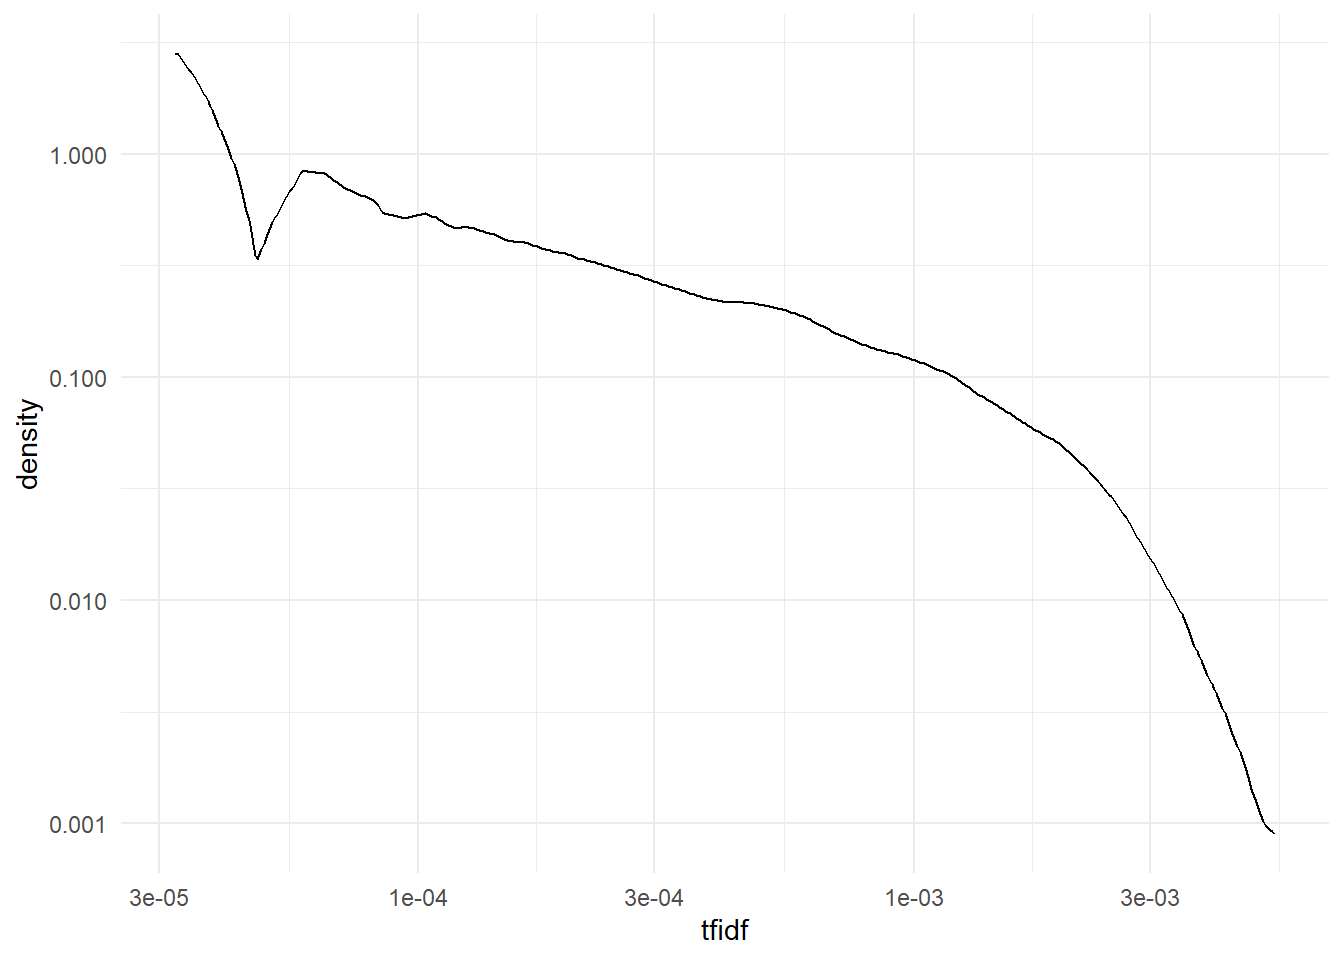
ggplot(tokens_lemma2, aes(x=tfidf))+geom_density(kernel = "triangular")+scale_x_log10()+scale_y_log10()

Code
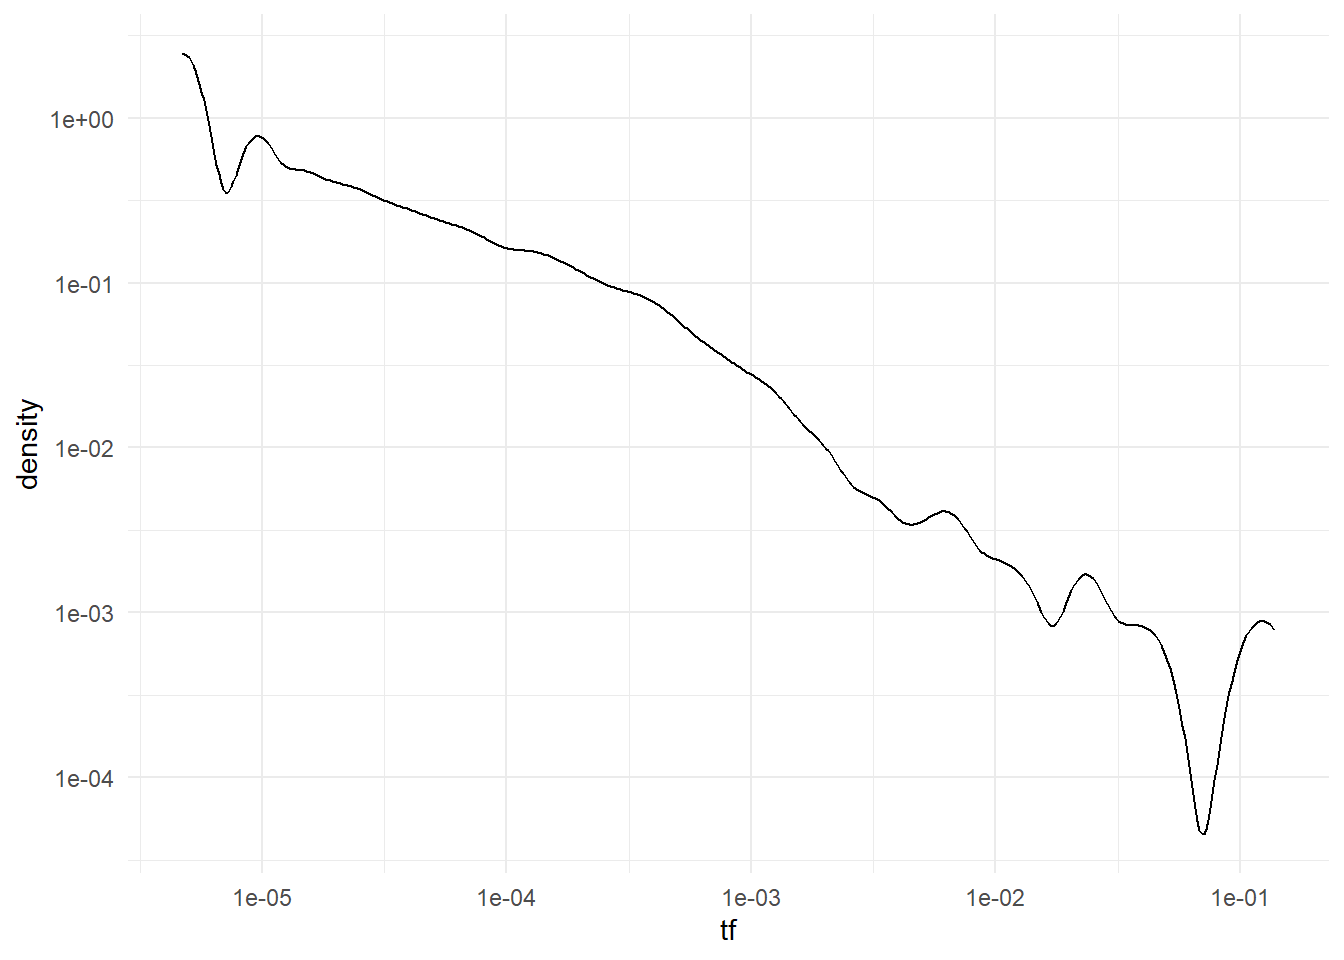
ggplot(tokens_lemma2, aes(x=tf))+geom_density(kernel = "gaussian")+scale_x_log10()+scale_y_log10()

filtrage des termes

On va filtrer cependant le vocabulaire et s’appuyer sur les lemmes de manière à réduire les variations morphologiques.

Code
toks<-tokens_lemma %>% 
  filter( upos %in% c("NOUN", "PROPN", "VERB", "ADJ", "ADV"))%>%
  select(Key,lemma)

text<-toks%>%
  group_by(Key)%>%
  summarise(text=paste0(lemma, collapse = " "))

On a donc un vocabulaire de \(n\) mots et un volume de $M\(101 000 mots environ répartit en ```\)N$``` 955 textes.

Construction du modèle

les hyper paramètre : 800 dim pour allez au plus est saisir le sémantique plutot que le syntaxique

une fenêtre plutoto large dans ce contexte les corrélations sot longues

le minimum fixé à 4 , car on ne veut rien perdre

Code
#library(word2vec)

#restructuration


model <- word2vec(x =text$text, 
                       type = "skip-gram", 
                       dim = 800, 
                       iter = 200, 
                       window=9,
                       min_count = 7, 
                       lr = 0.04, 
                       threads = 4)

words <- as.matrix(model)


lookslike <- predict(model, c( "service", "public" ), type = "nearest", top_n = 20)
lookslike
$service
     term1      term2 similarity rank
1  service      œuvre  0.7635384    1
2  service       état  0.7267305    2
3  service évaluation  0.7149113    3
4  service    système  0.7133485    4
5  service  évolution  0.7105619    5
6  service économique  0.7104794    6
7  service      étude  0.7078722    7
8  service     social  0.7033300    8
9  service   évidence  0.7028862    9
10 service       tout  0.7004151   10
11 service    secteur  0.6968539   11
12 service    évaluer  0.6858956   12
13 service  également  0.6840497   13
14 service       très  0.6788934   14
15 service    élément  0.6788385   15
16 service     public  0.6784084   16
17 service    souvent  0.6782345   17
18 service       type  0.6779736   18
19 service      viser  0.6753900   19
20 service        élu  0.6751122   20

$public
    term1      term2 similarity rank
1  public    pouvoir  0.7040223    1
2  public  politique  0.6982924    2
3  public      œuvre  0.6982276    3
4  public  processus  0.6980888    4
5  public      étude  0.6950630    5
6  public   question  0.6930346    6
7  public évaluation  0.6924482    7
8  public  évolution  0.6842593    8
9  public       état  0.6839386    9
10 public       plus  0.6808208   10
11 public    service  0.6784084   11
12 public   évidence  0.6660100   12
13 public   proposer  0.6657009   13
14 public   relation  0.6656160   14
15 public économique  0.6626582   15
16 public    rapport  0.6587083   16
17 public    secteur  0.6580645   17
18 public     social  0.6551687   18
19 public    prendre  0.6543925   19
20 public   problème  0.6537768   20
Code
wv <- predict(model, newdata = c("gestion", "management"), type = "embedding")
wv <- wv["gestion", ] + wv["management", ] 
predict(model, newdata = wv, type = "nearest", top_n = 30)
          term similarity rank
1    important  0.8556010    1
2       mettre  0.8406599    2
3     français  0.8215879    3
4        local  0.8177455    4
5   instrument  0.8136908    5
6        grand  0.8064154    6
7      imposer  0.8058695    7
8     fonction  0.8040430    8
9         mise  0.8026327    9
10     montrer  0.8023306   10
11       faire  0.7973899   11
12  managérial  0.7956975   12
13     intérêt  0.7933522   13
14     général  0.7925041   14
15          ne  0.7911944   15
16   largement  0.7903871   16
17         loi  0.7842203   17
18         ici  0.7825220   18
19        mode  0.7810031   19
20      impact  0.7803668   20
21      marché  0.7800300   21
22  expérience  0.7790010   22
23       mener  0.7780996   23
24     manière  0.7778259   24
25 information  0.7768611   25
26        même  0.7724776   26
27           n  0.7698081   27
28     logique  0.7680975   28
29       gérer  0.7671672   29
30      fonder  0.7668622   30

words embeddings

donc on va chercher à calculer d’autres statistiques, en particulier le score tfidf des termes (leurs discriminence)

On va ajouter ces informations aux words embeddings pour une présentation synthétique.

le vocabulaire de 3600 est trop gros pour être représenté. On va donc sélectionner les mots les plus discriminant au titre de la métrique du tidf.

Quelques précisions sur la méthode UMAP.

Code
# les mots

emb_word<-as.data.frame(words)

#umap representation

library(uwot)
word_umap <- as.data.frame(umap(emb_word, n_neighbors = 5,   n_components = 2,
learning_rate = 0.5, init = "random")) %>%
  rownames_to_column(var="lemma")%>%
  rename(d1=V1, d2=V2) %>% 
  left_join(tokens_lemma2) %>%
  cbind(emb_word)

# Dissimilarity matrix
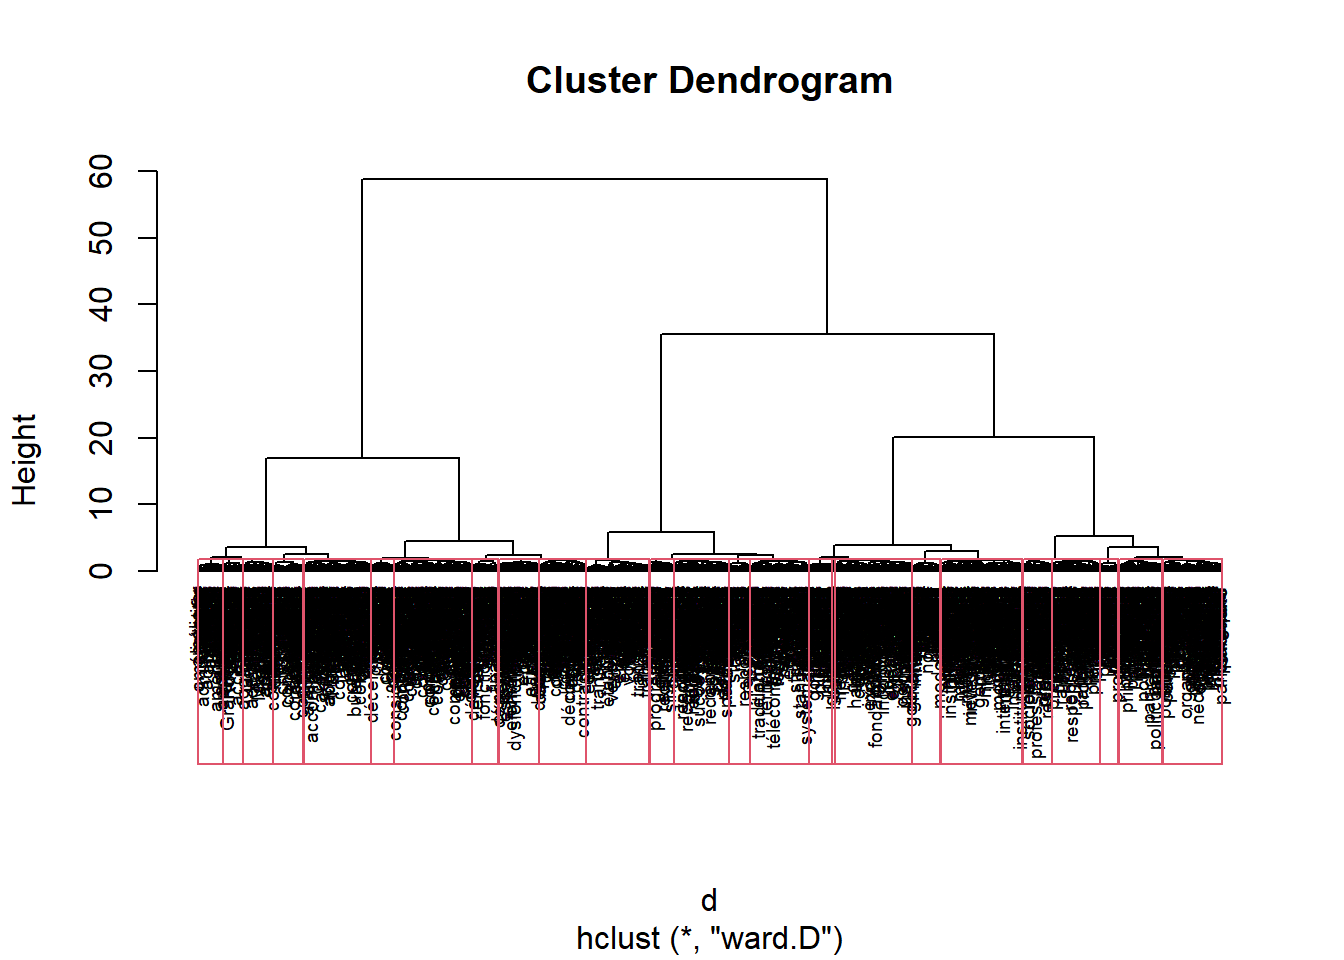
d <- as.dist(1-cor(t(word_umap[10:809])))

# Hierarchical clustering using ward
hc1 <- hclust(d, method = "ward.D" )

# Plot the obtained dendrogram
plot(hc1, cex = 0.6, hang = -1)
rect.hclust(hc1, k = 25)

Code
mytree = cutree(hc1, k=25) # combien de  catégories ?

foo<-cbind(word_umap, mytree)%>% 
  mutate(mytree=factor(mytree))

set.seed(42)

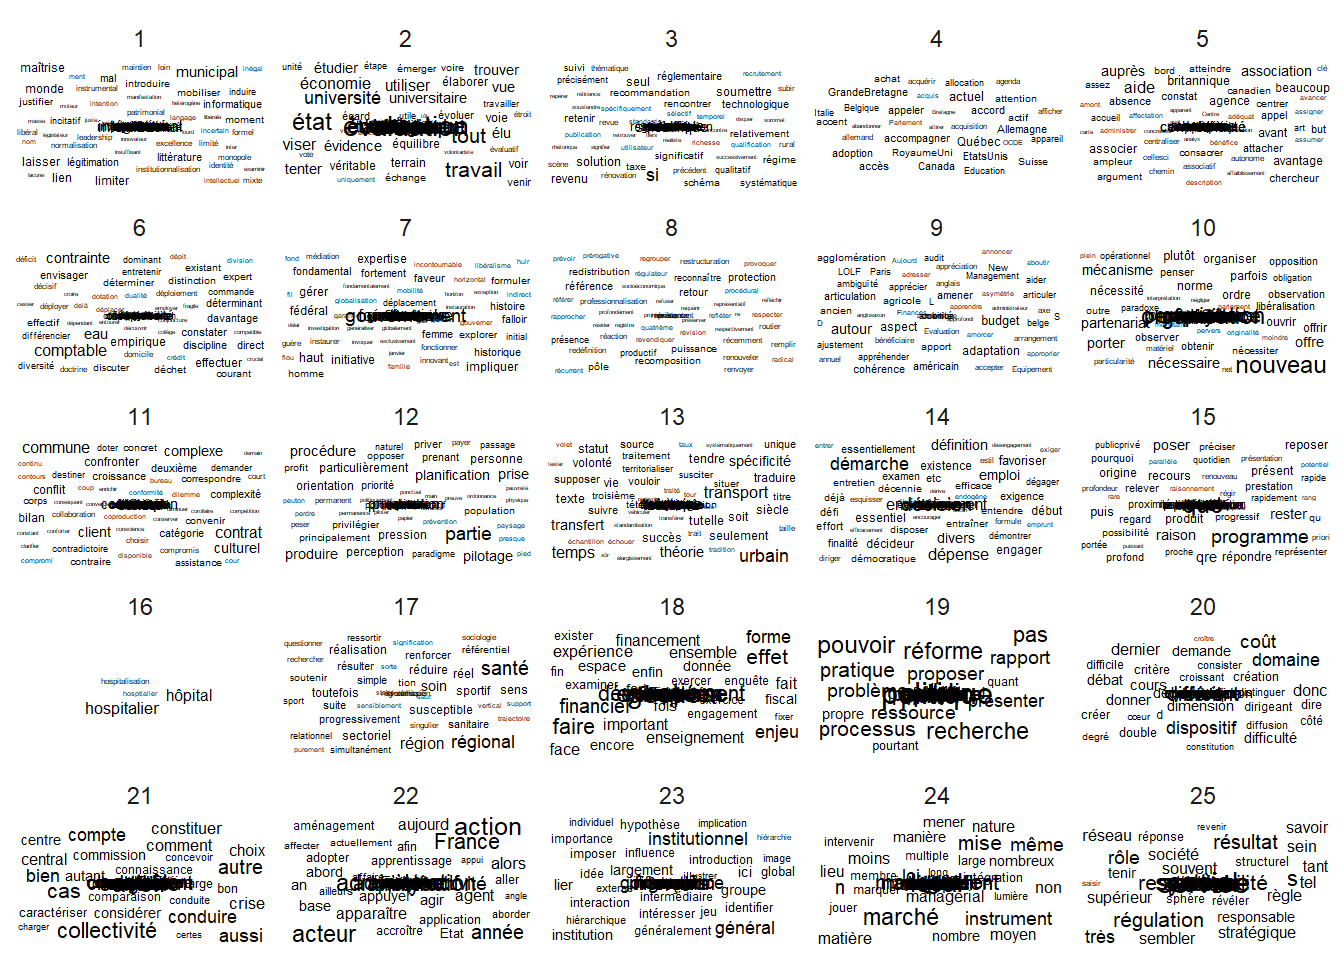
p<-ggplot(foo, aes(label = lemma, size = tfidf)) +
  geom_text_wordcloud() +
  scale_size_area(max_size = 4) +
  theme_minimal()+
  facet_wrap(~mytree)
p

Code
ggsave("./images/vector01.jpeg", plot=p,width = 27, height = 18, units = "cm")


p<-ggplot(foo, aes(x=V1,y=V2, group=lemma))+
  geom_text(aes(label=lemma, size=tfidf, color=mytree))

fig <- ggplotly(p)

fig
Code
#


library(htmlwidgets)
saveWidget(fig, "p1.html", selfcontained = F, libdir = "lib")

text embeddings

Code
emb_doc<-doc2vec(model, text$text, split = " ") 
rownames(emb_doc)<-text$Key

doc_umap <- as.data.frame(umap(emb_doc, n_neighbors = 5,   
                               n_components = 2,
                               learning_rate = 0.5, 
                               init = "random")) %>%
  rownames_to_column(var="id")%>%
  rename(d1=V1, d2=V2)

doc_umap <- doc_umap %>% cbind(dn[,1:4])

#typologie
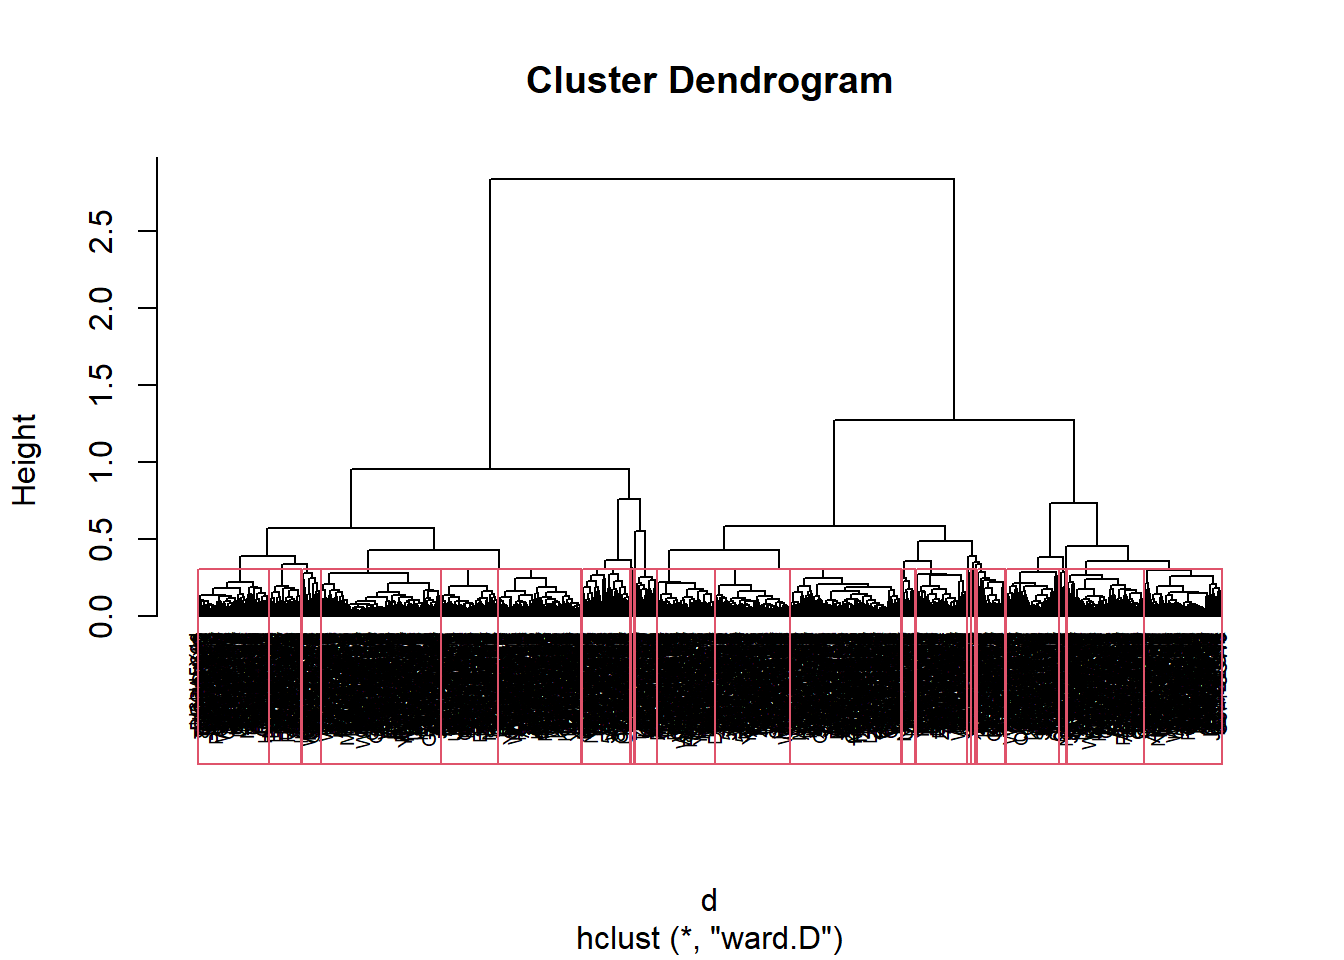
d <- as.dist(1-cor(t(emb_doc)))

# Hierarchical clustering using Complete Linkage
hc1 <- hclust(d, method = "ward.D" )

# Plot the obtained dendrogram
plot(hc1, cex = 0.6, hang = -1)
rect.hclust(hc1, k = 25)

Code
mytree = cutree(hc1, k=25) # combien de  catégories ?


doc_umap<-cbind(doc_umap, mytree)

#graph

p<-ggplot(doc_umap, aes(x=d1, y=d2,  label=Title)) +
  geom_point(aes(color=as.factor(mytree)),size=.5)


fig <- ggplotly(p)

fig

tester des concepts

Un concept est formé d’une phrase composée des mots clés qui s’y rapportent, on les élabore progressivement par ajustements successif en les empruntant dans le dictionnaire.
Code
concept<-data.frame( id=c("Gestion", "Contrôle", "PolitiquePublique", "Performance"),
           text=c("gestion management",
                  "contrôle évaluation contrôler",
                  "politique public",
                  "performance résultat efficacité rendement"))

emb_concept<-doc2vec(model, concept$text, split = " ", encoding = "UTF-8")

rownames(emb_concept)<-concept$id

    
library(lsa)
foo<-rbind(emb_concept, emb_doc)
cos<-cosine(t(foo) )

cos2<-cos %>%as.data.frame()%>%
  select(1:nrow(emb_concept)) 

a<-as.numeric(nrow(emb_concept))+1

b<-as.numeric(nrow(emb_doc))+as.numeric(nrow(emb_concept))

cos2<-cos2[a:b,] %>%as.data.frame()%>%
  rownames_to_column(var="Key")%>%left_join(dn)

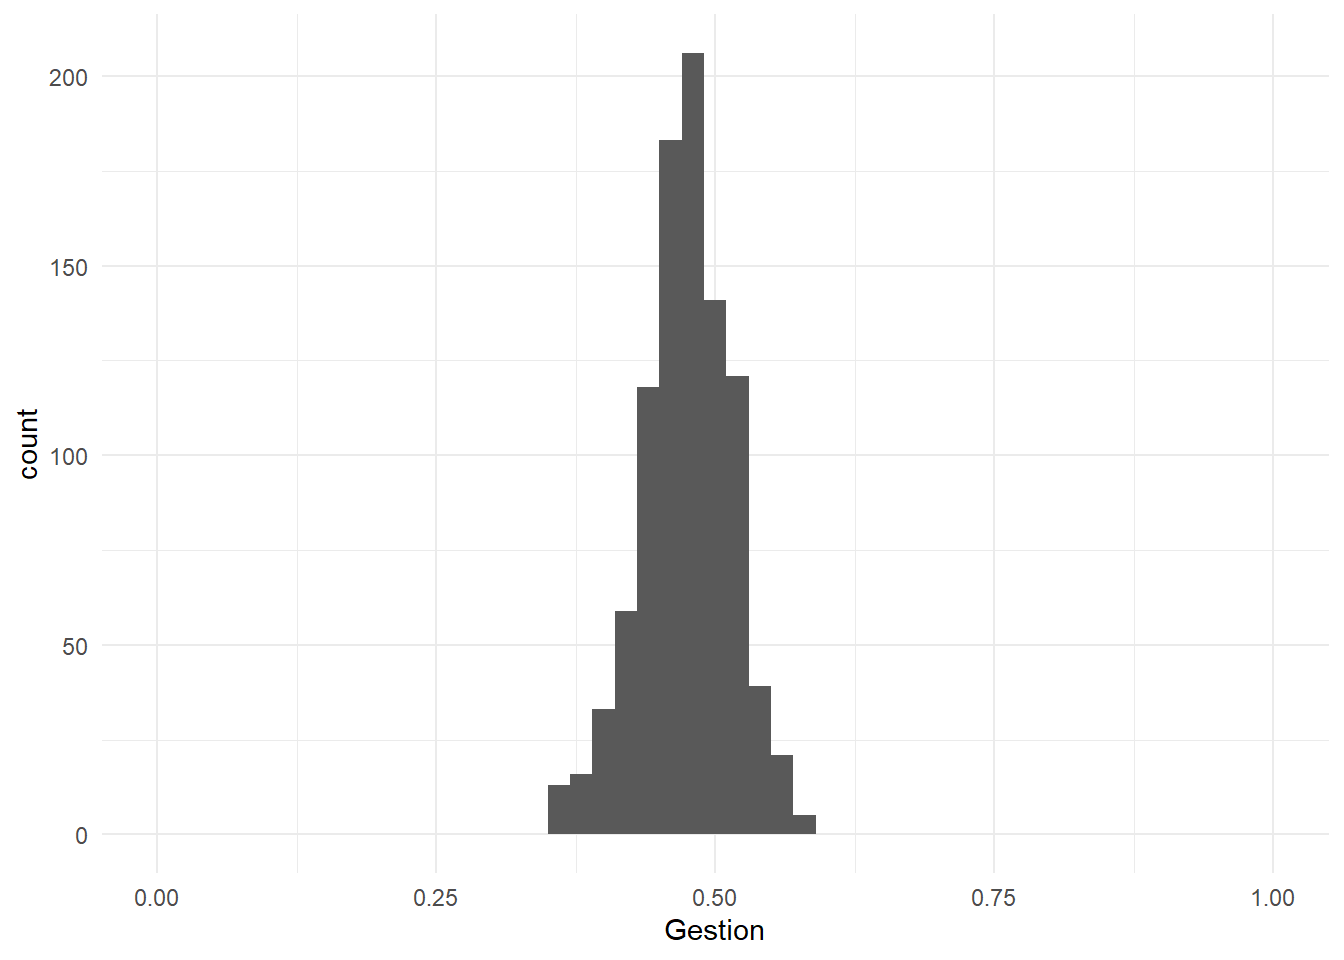
ggplot(cos2, aes(x=Gestion))+geom_histogram(binwidth=.02)+xlim(0, 1)

Code
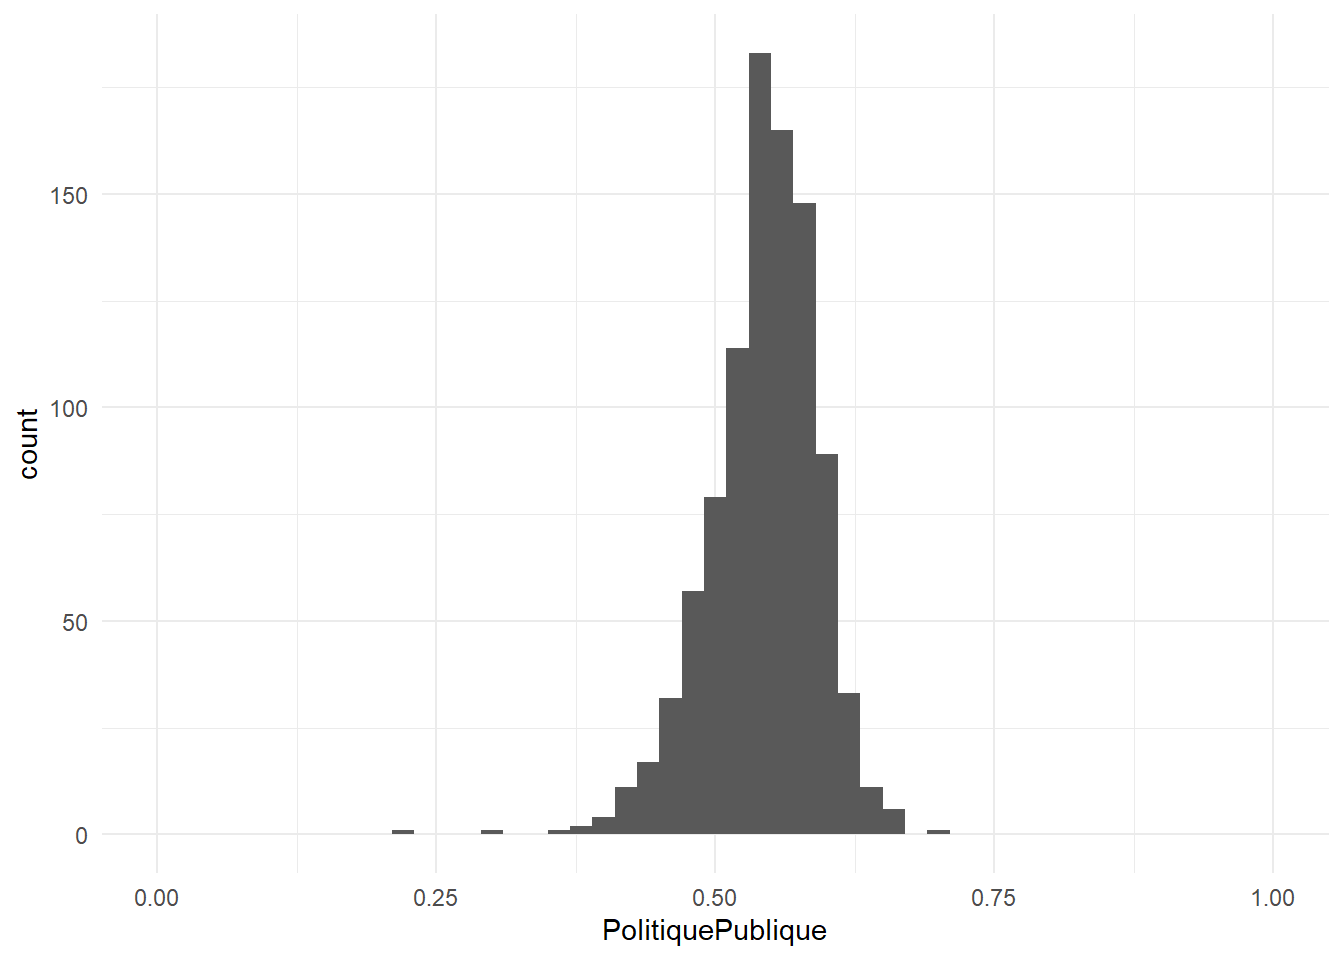
ggplot(cos2, aes(x=PolitiquePublique))+geom_histogram(binwidth=.02) +xlim(0, 1)

Code
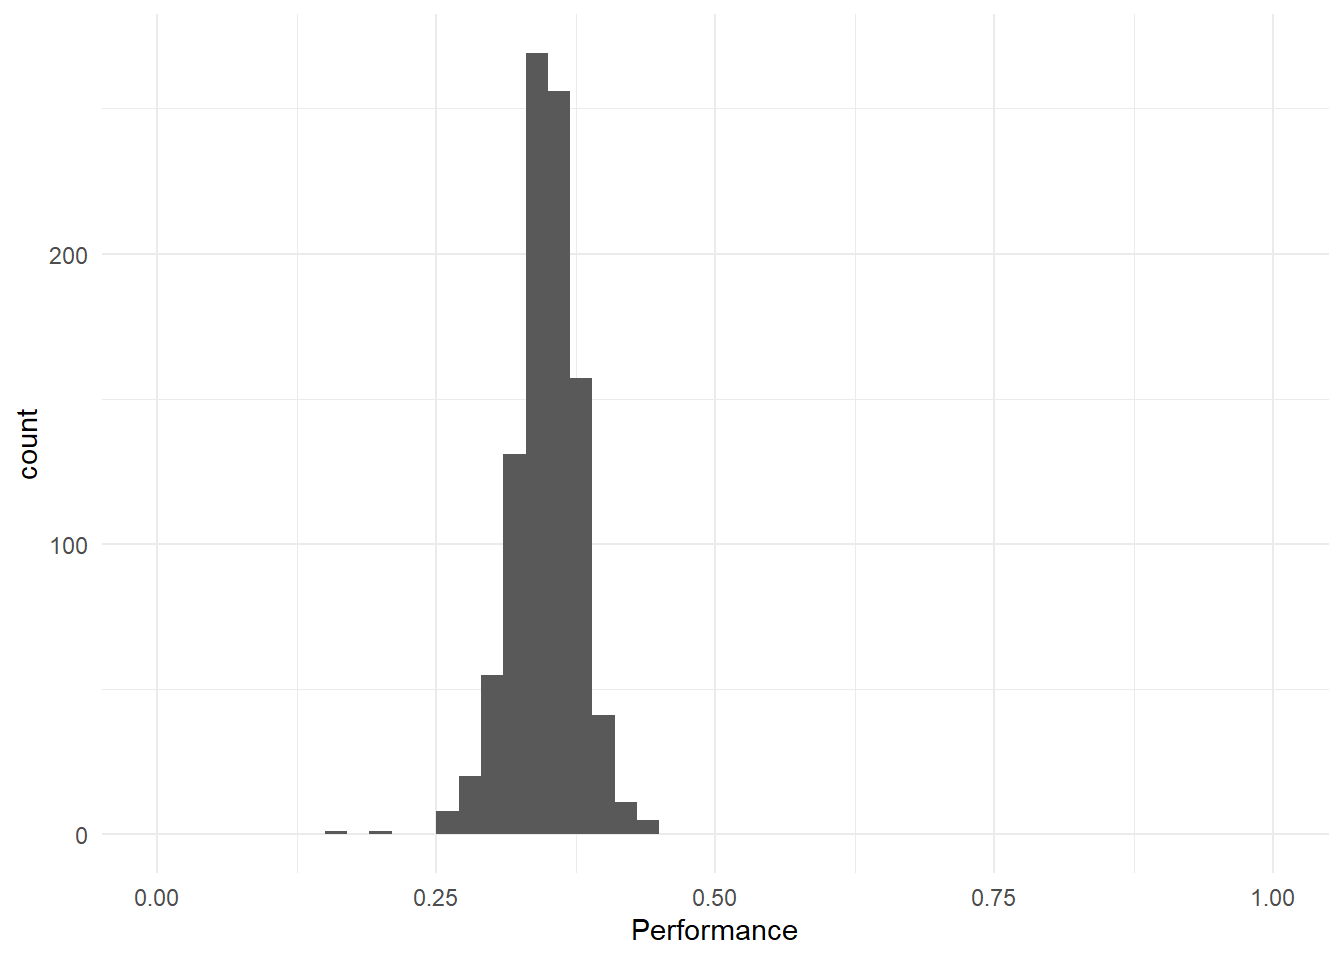
ggplot(cos2, aes(x=Performance))+geom_histogram(binwidth=.02) +xlim(0, 1)

Code
foo<- cos2 %>%group_by(Year)%>%summarise(Gestion = mean(Gestion, na.rm=TRUE))

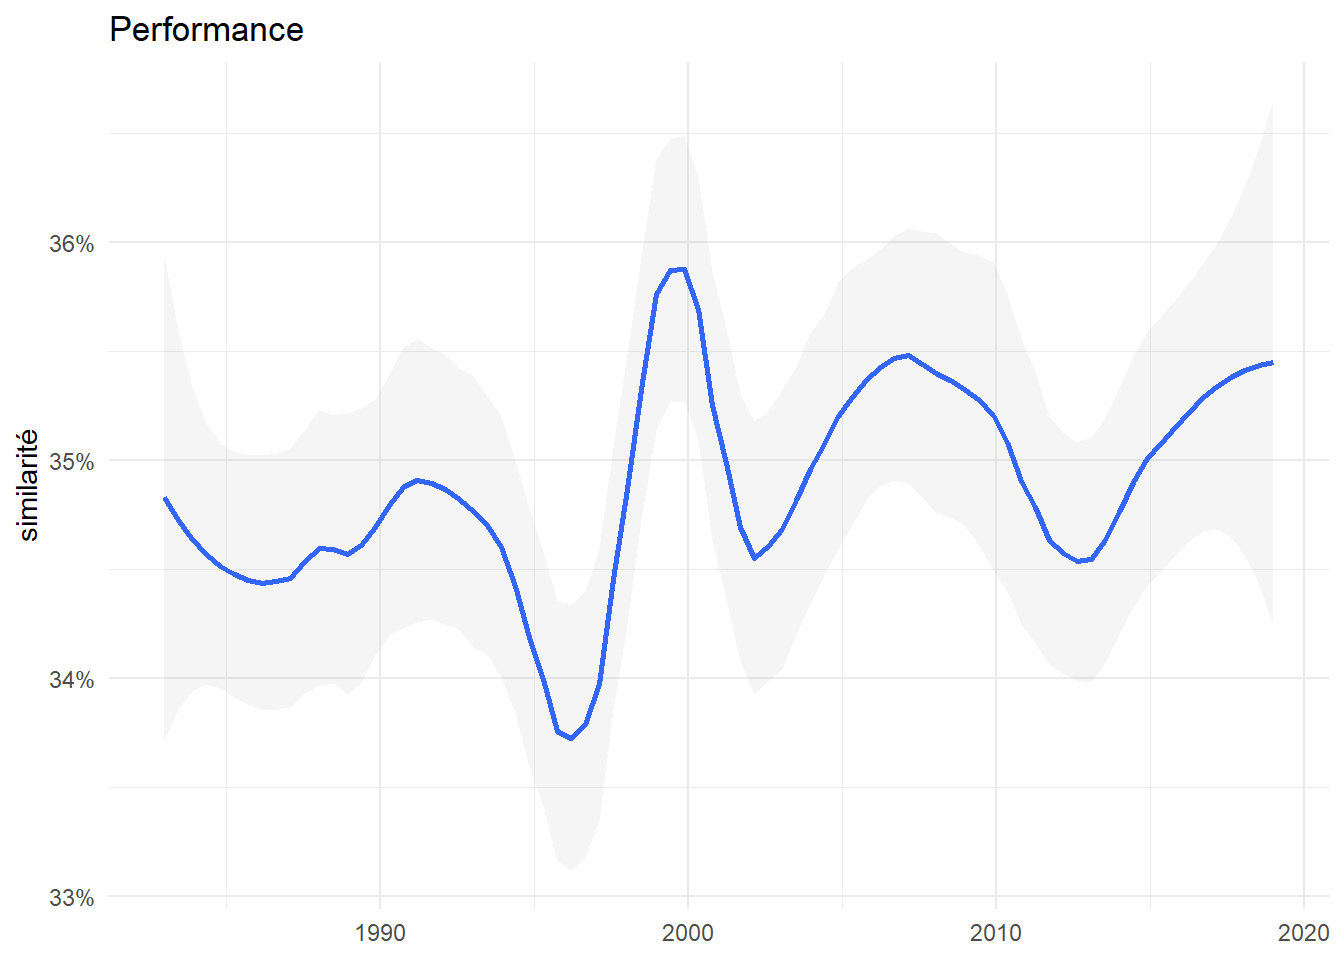
ggplot(cos2, aes(x=Year, y=Performance, group=1))+
  geom_smooth(method="loess", alpha=0.1,span=0.25)+
  scale_color_manual(values = col)+
  scale_y_continuous(labels=scales::percent, limits=c(NA, NA))+
  labs(y="similarité", x=NULL, title = "Performance")

Code
ggsave("./images/keyword_w2v.jpeg", width = 27, height = 18, units = "cm")