Rap francais

rappeur

Stylométrie

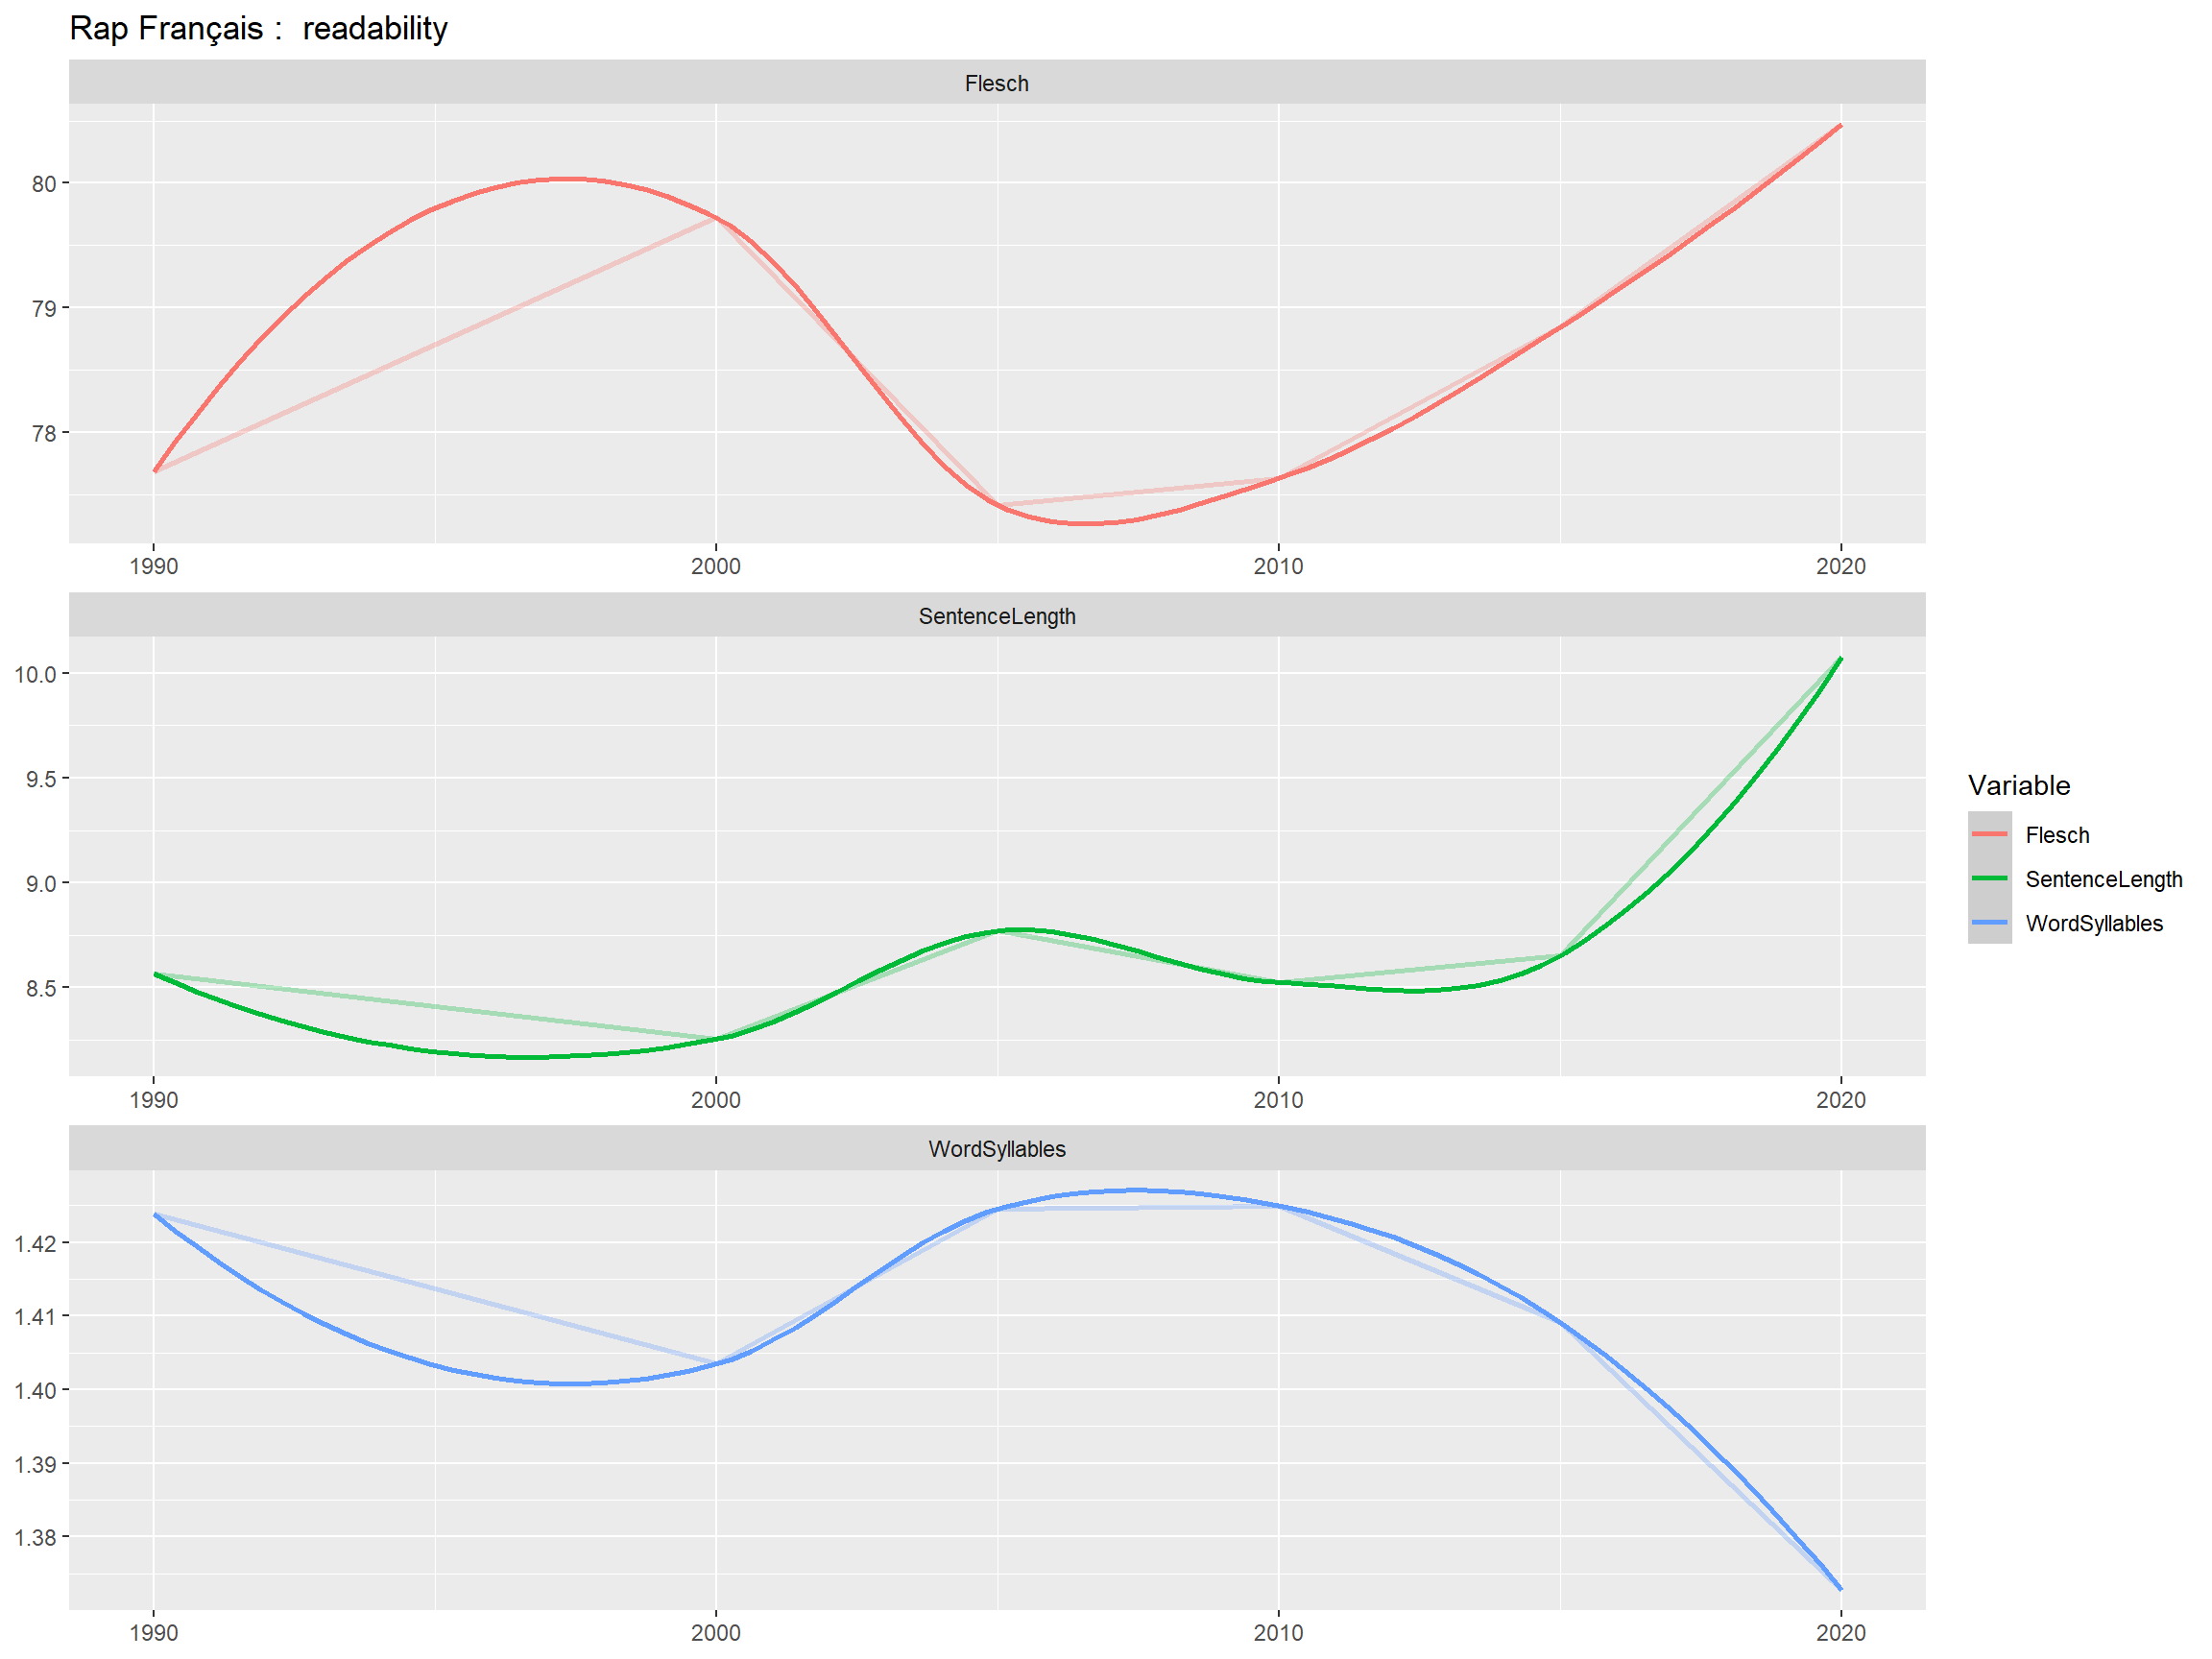
Lisibilité

Le rap c’est difficile à lire . Les scores de lisibilités sont incalculables, car la phrase est dissoutes, la ponctuation disparue. D’ailleurs la ponctuation est venue tardivement, le latin n’en avait pas. Qu’est-ce qui fait une phrase en l’absence de ponctuation ? La structure de la rime ? Le tempo de la phrase? Avons nous les outils ?

Le rap est un langage initiatique et ésotérique, un langage cryptique. plus difficile à lire que la philosophie. Les IA n’arrivent même pas bien à détecter leur langue.

Un biais apparaît par le fait que les transcriptions en vers, ignorent la ponctuation …. et produisent des phrases longues.

library(tidyverse)
library(quanteda)
library(quanteda.textmodels)
library(quanteda.textstats)
library(ggwordcloud)
library(quanteda.textplots)
library(tidytext)
library(udpipe) 
library(Rtsne)
library(ggrepel)
library(seededlda)

# syntaxis and lexical annotations

My_Theme = theme(
  axis.title.x = element_text(size = 10),
  axis.text.x = element_text(size = 7),
  axis.text.y = element_text(size = 7),
  axis.title.y = element_text(size = 10))

theme_set(theme_minimal()+ theme_set(theme_minimal()))


text1<-read.csv("RapLyrics.csv")

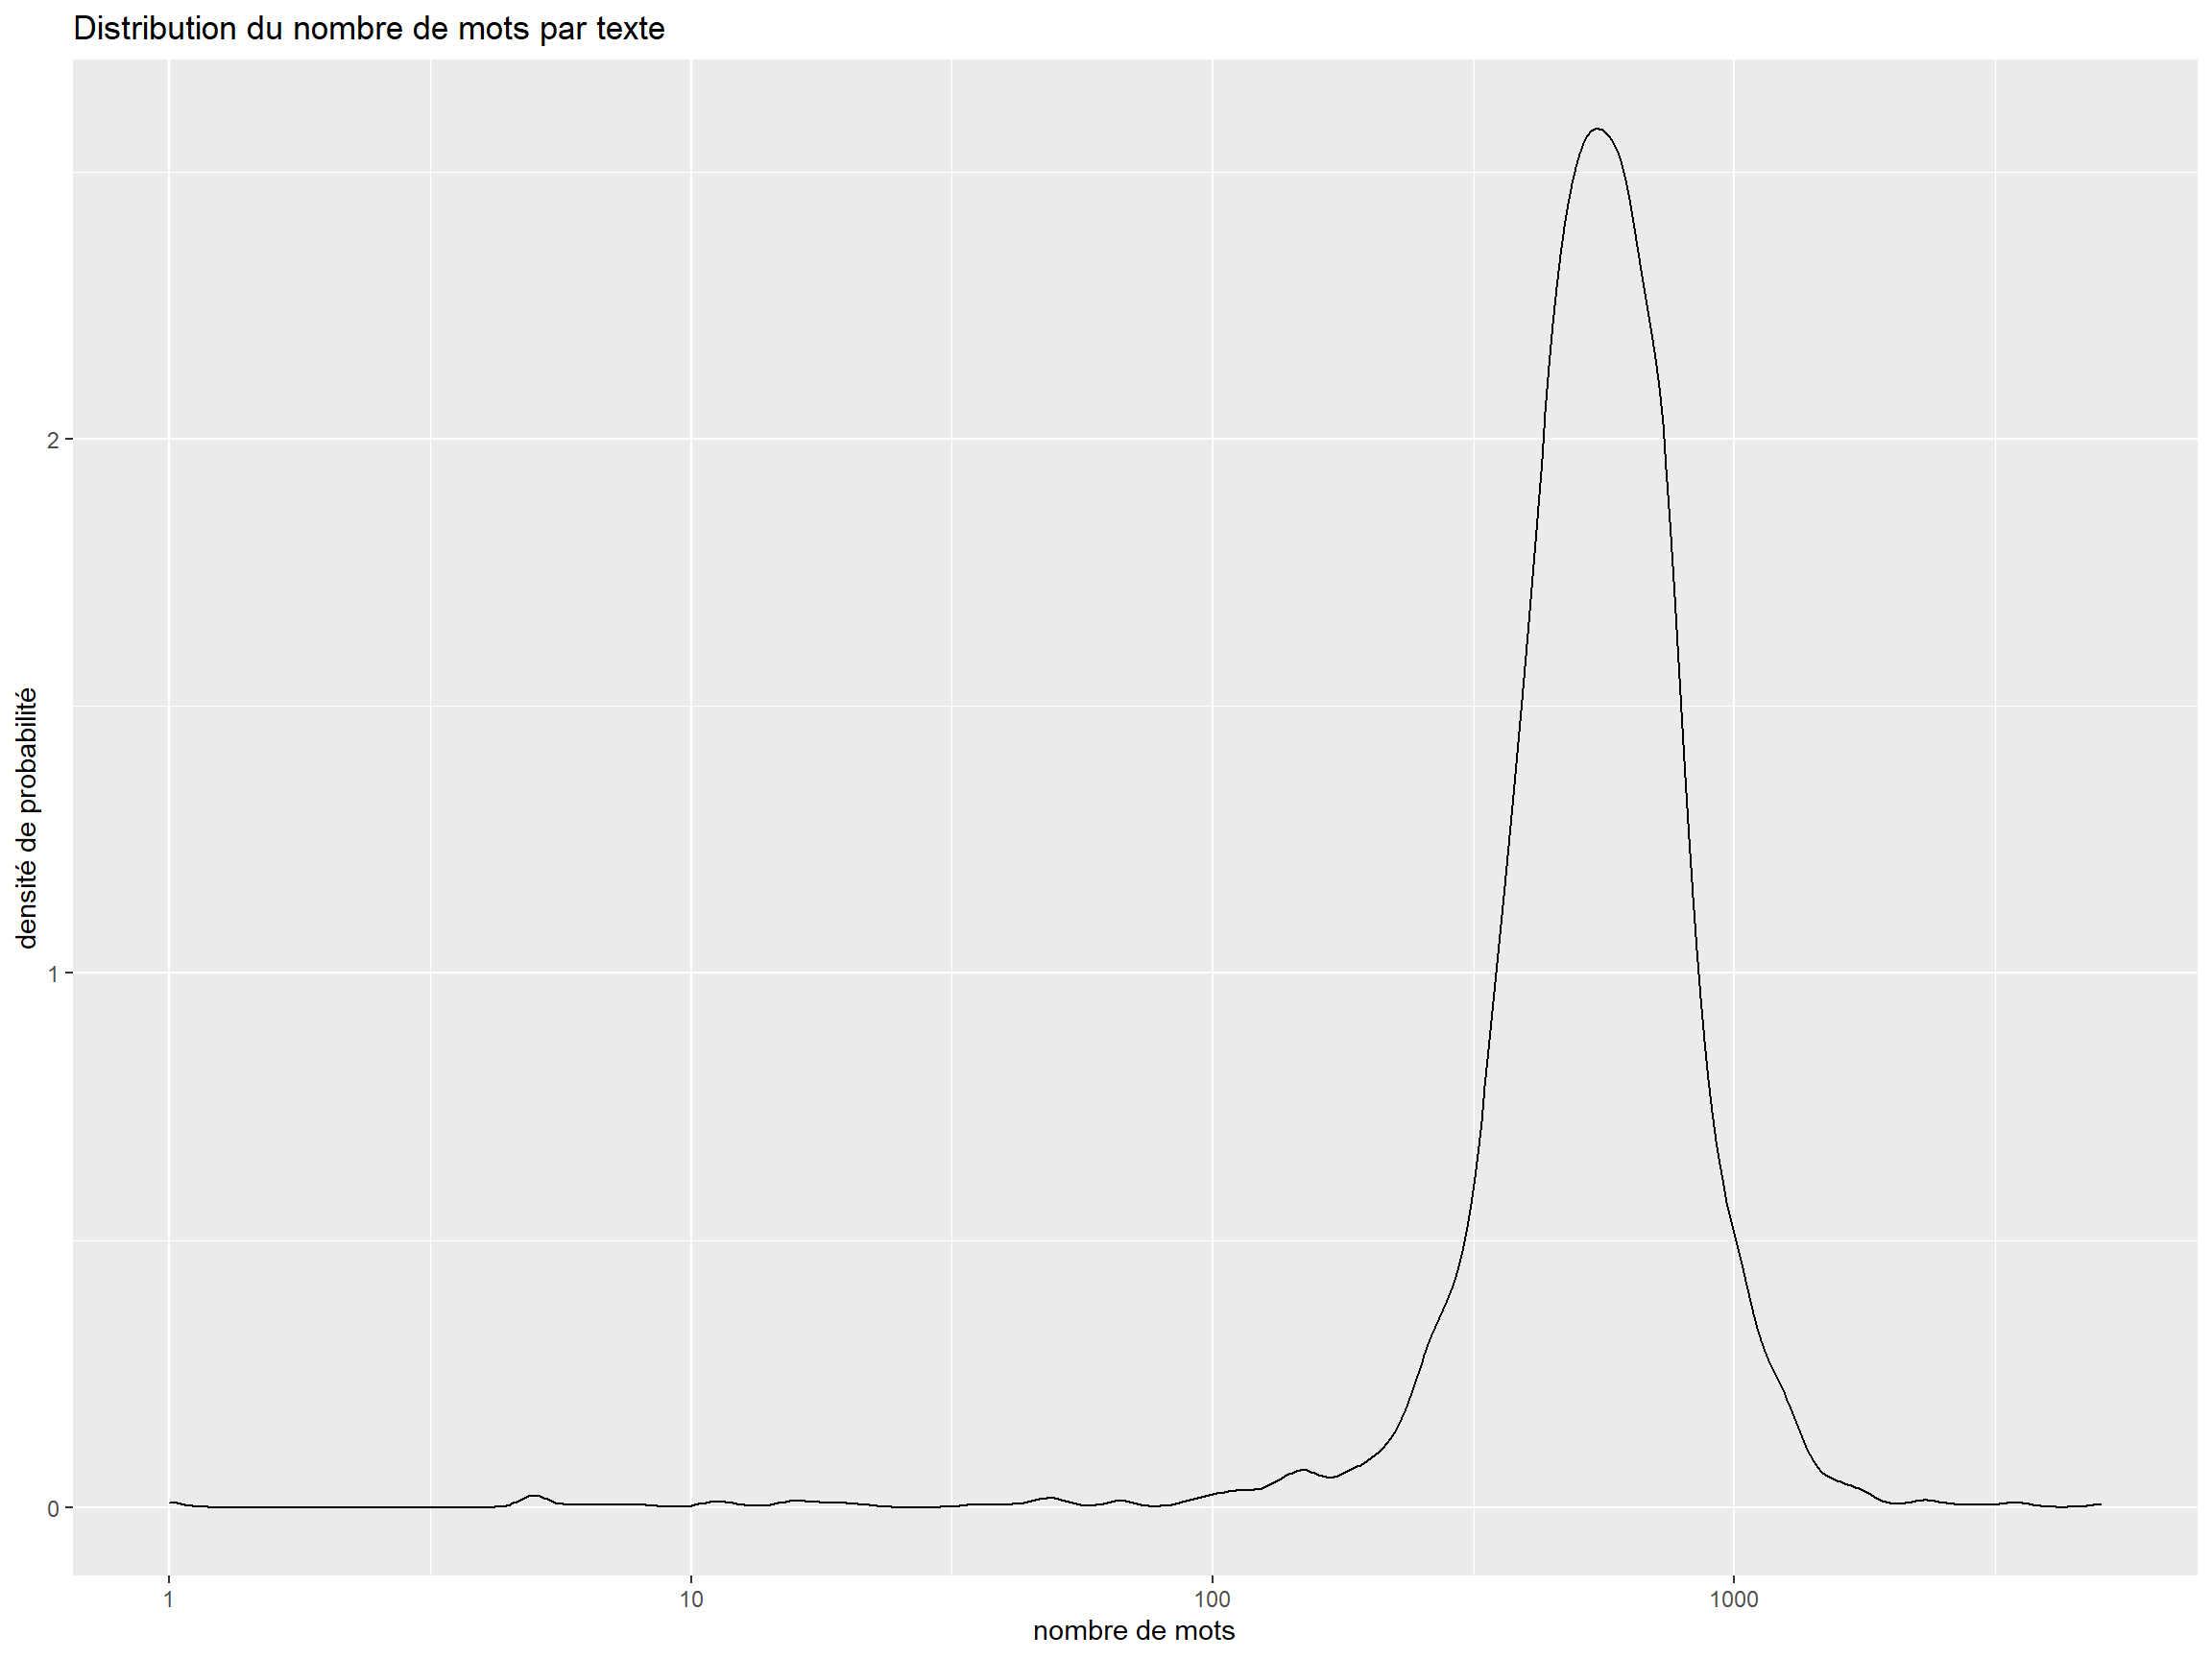
ggplot(text1,aes(x=n_words))+
  geom_density()+ 
  scale_x_log10()+ 
  labs( title = "Distribution du nombre de mots par texte",
                         x= "nombre de mots",
                         y= "densité de probabilité")

#la fonction de calcul de lisibilité
#une fonction impossible
readability<-textstat_readability(text1$Paroles, 
                                  measure = c("Flesch",
                                              "meanSentenceLength",
                                              "meanWordSyllables")) 

foo<-cbind(text1[,1:10],readability[,2:4])

foo1<-foo %>%
  group_by(quinc) %>%
  summarise(Flesch=mean(Flesch, na.rm=TRUE), 
            SentenceLength= mean(meanSentenceLength, na.rm=TRUE),
            WordSyllables= mean(meanWordSyllables, na.rm=TRUE)) %>%
  pivot_longer(-quinc,names_to="Variable", values_to="Score")

ggplot(foo1,aes(x=quinc, y=Score, group=Variable))+
  geom_line(size=1, aes(color=Variable), stat="identity", alpha=0.3)+
  geom_smooth(aes(color=Variable))+
  facet_wrap(vars(Variable), scale="free", ncol=1)+
  labs(title = "Rap Français :  readability", x=NULL, y=NULL)

foo1<-foo %>%
  group_by(Artiste) %>%
  summarise(Flesch=mean(Flesch, na.rm=TRUE), 
            SentenceLength= mean(meanSentenceLength, na.rm=TRUE),
            WordSyllables= mean(meanWordSyllables, na.rm=TRUE))

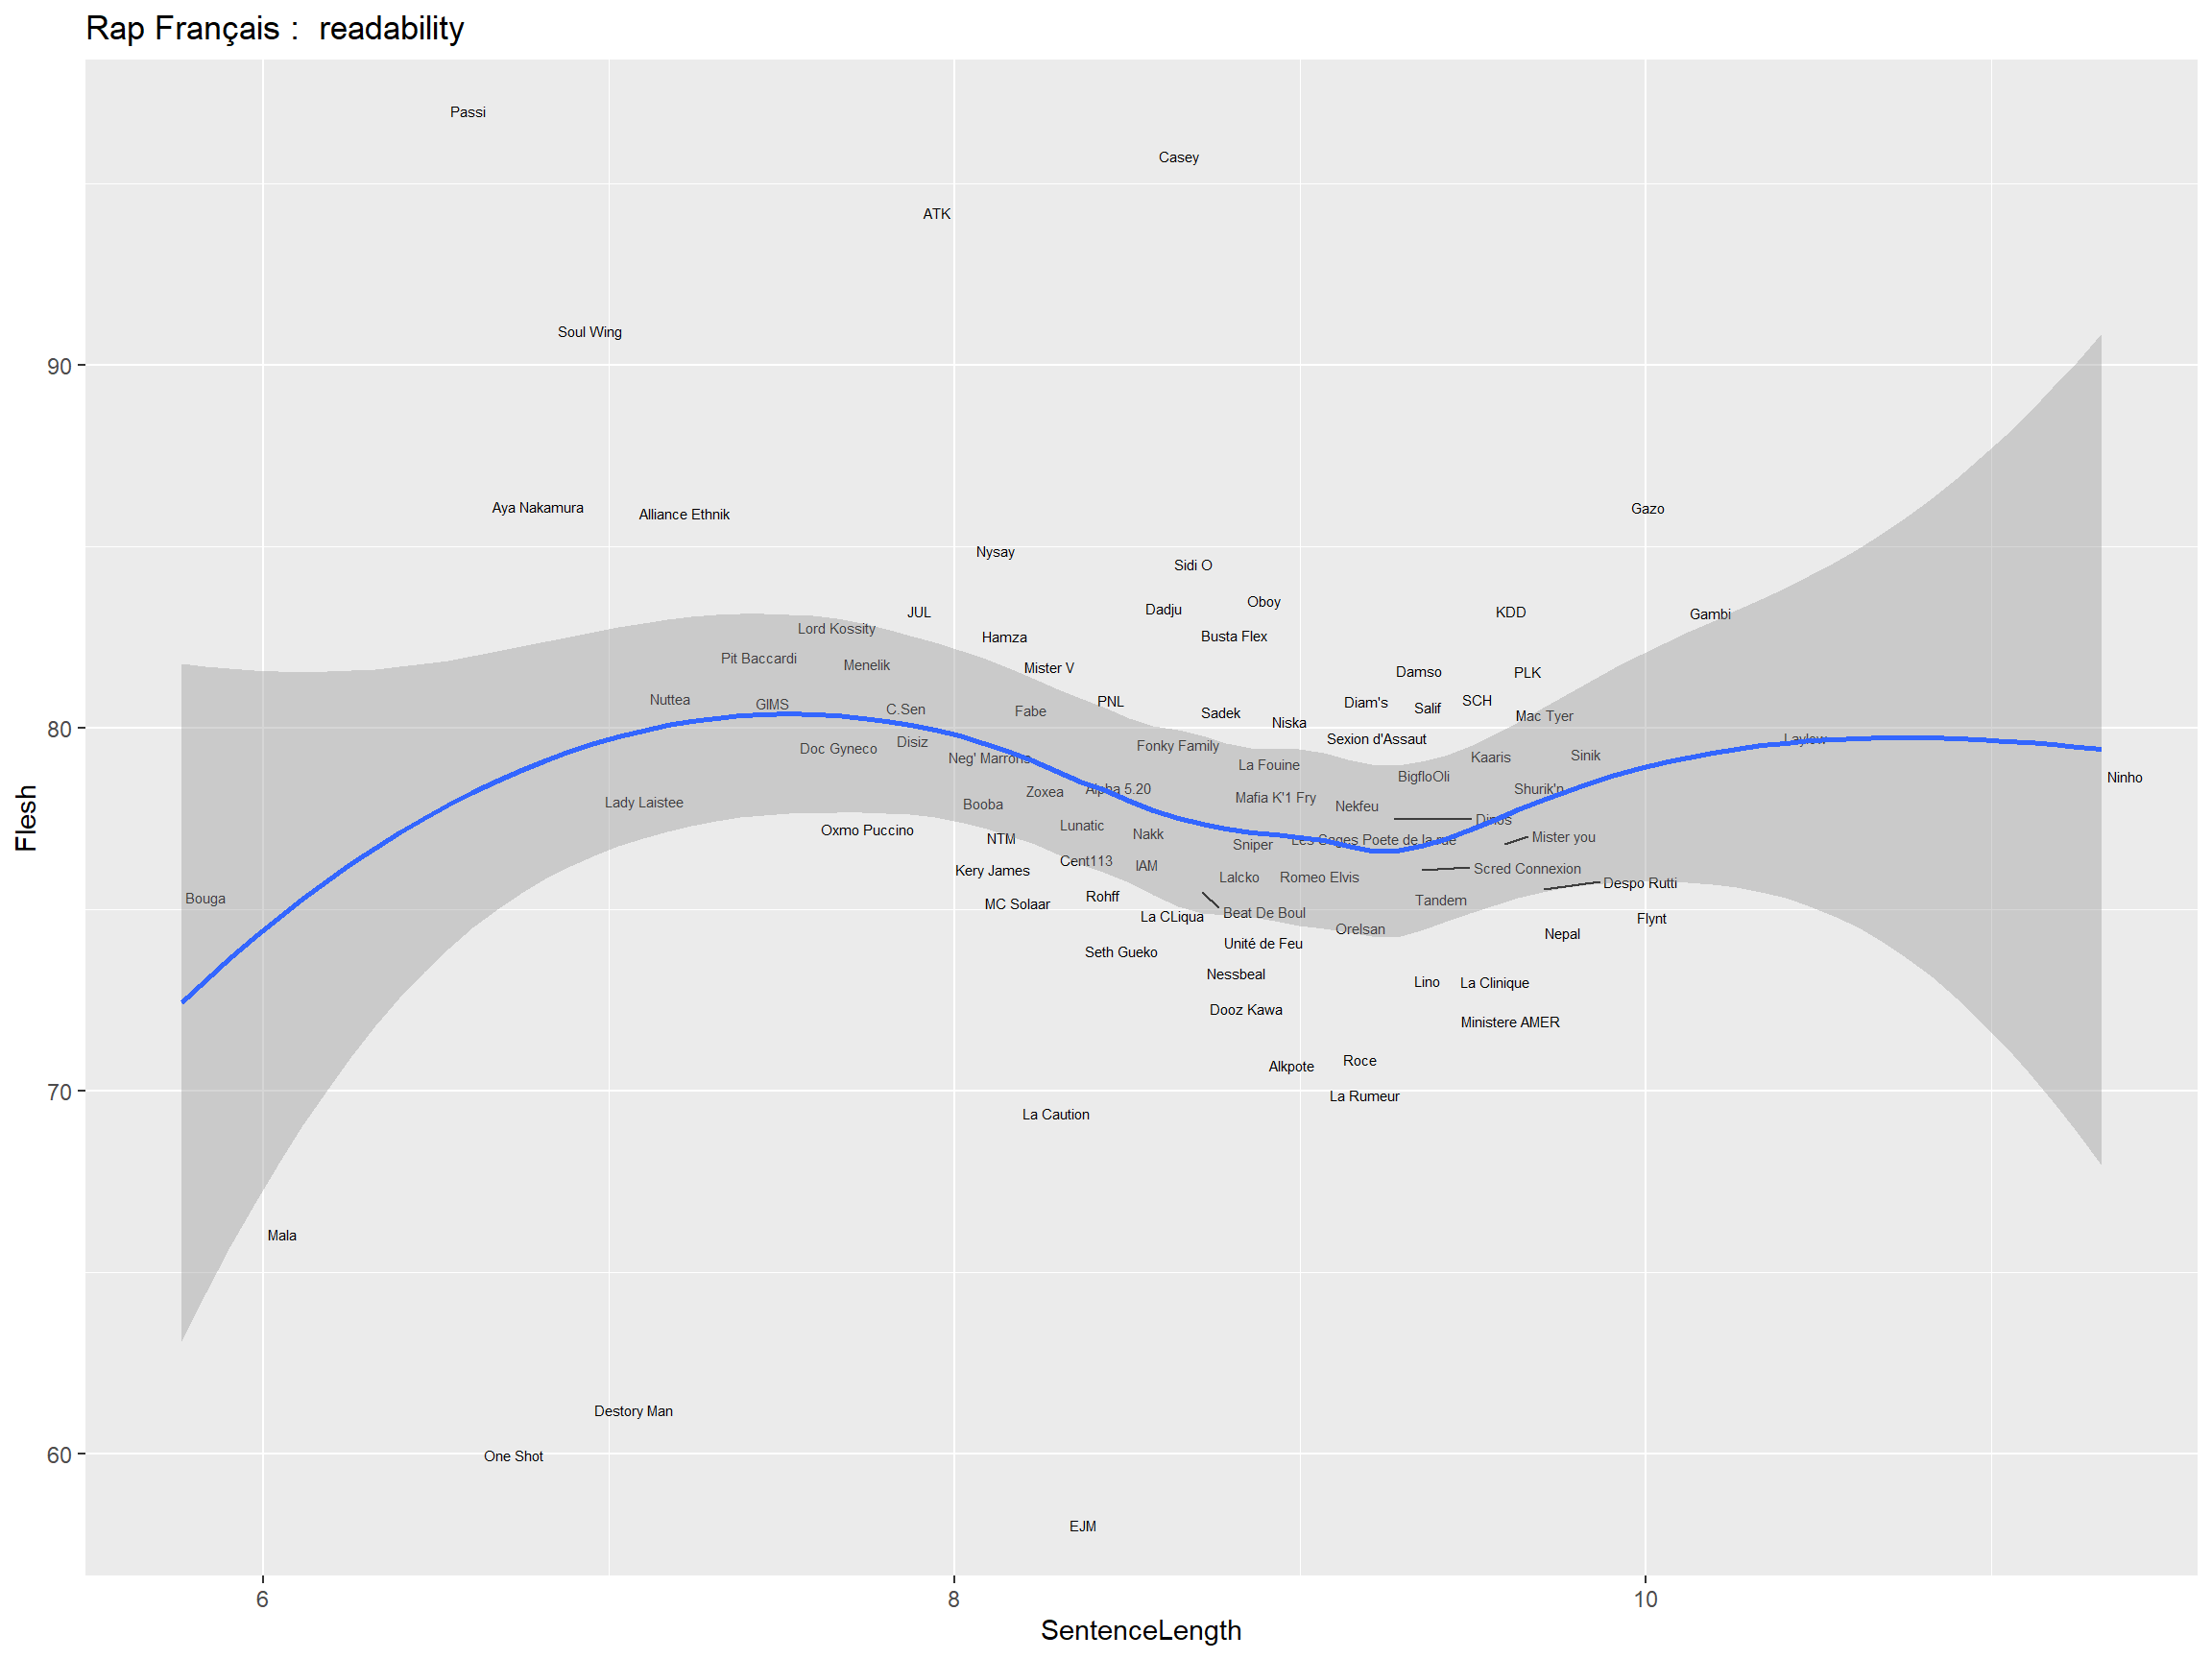
ggplot(foo1,aes(label=Artiste, y=Flesch, x=SentenceLength))+
  geom_text_repel(aes(label=Artiste, size=n_words), stat="identity", size=2, max.overlaps =50)+
  labs(title = "Rap Français :  readability", 
       x="SentenceLength", 
       y="Flesh")+ geom_smooth()+
    scale_size(range = c(.1, 4))

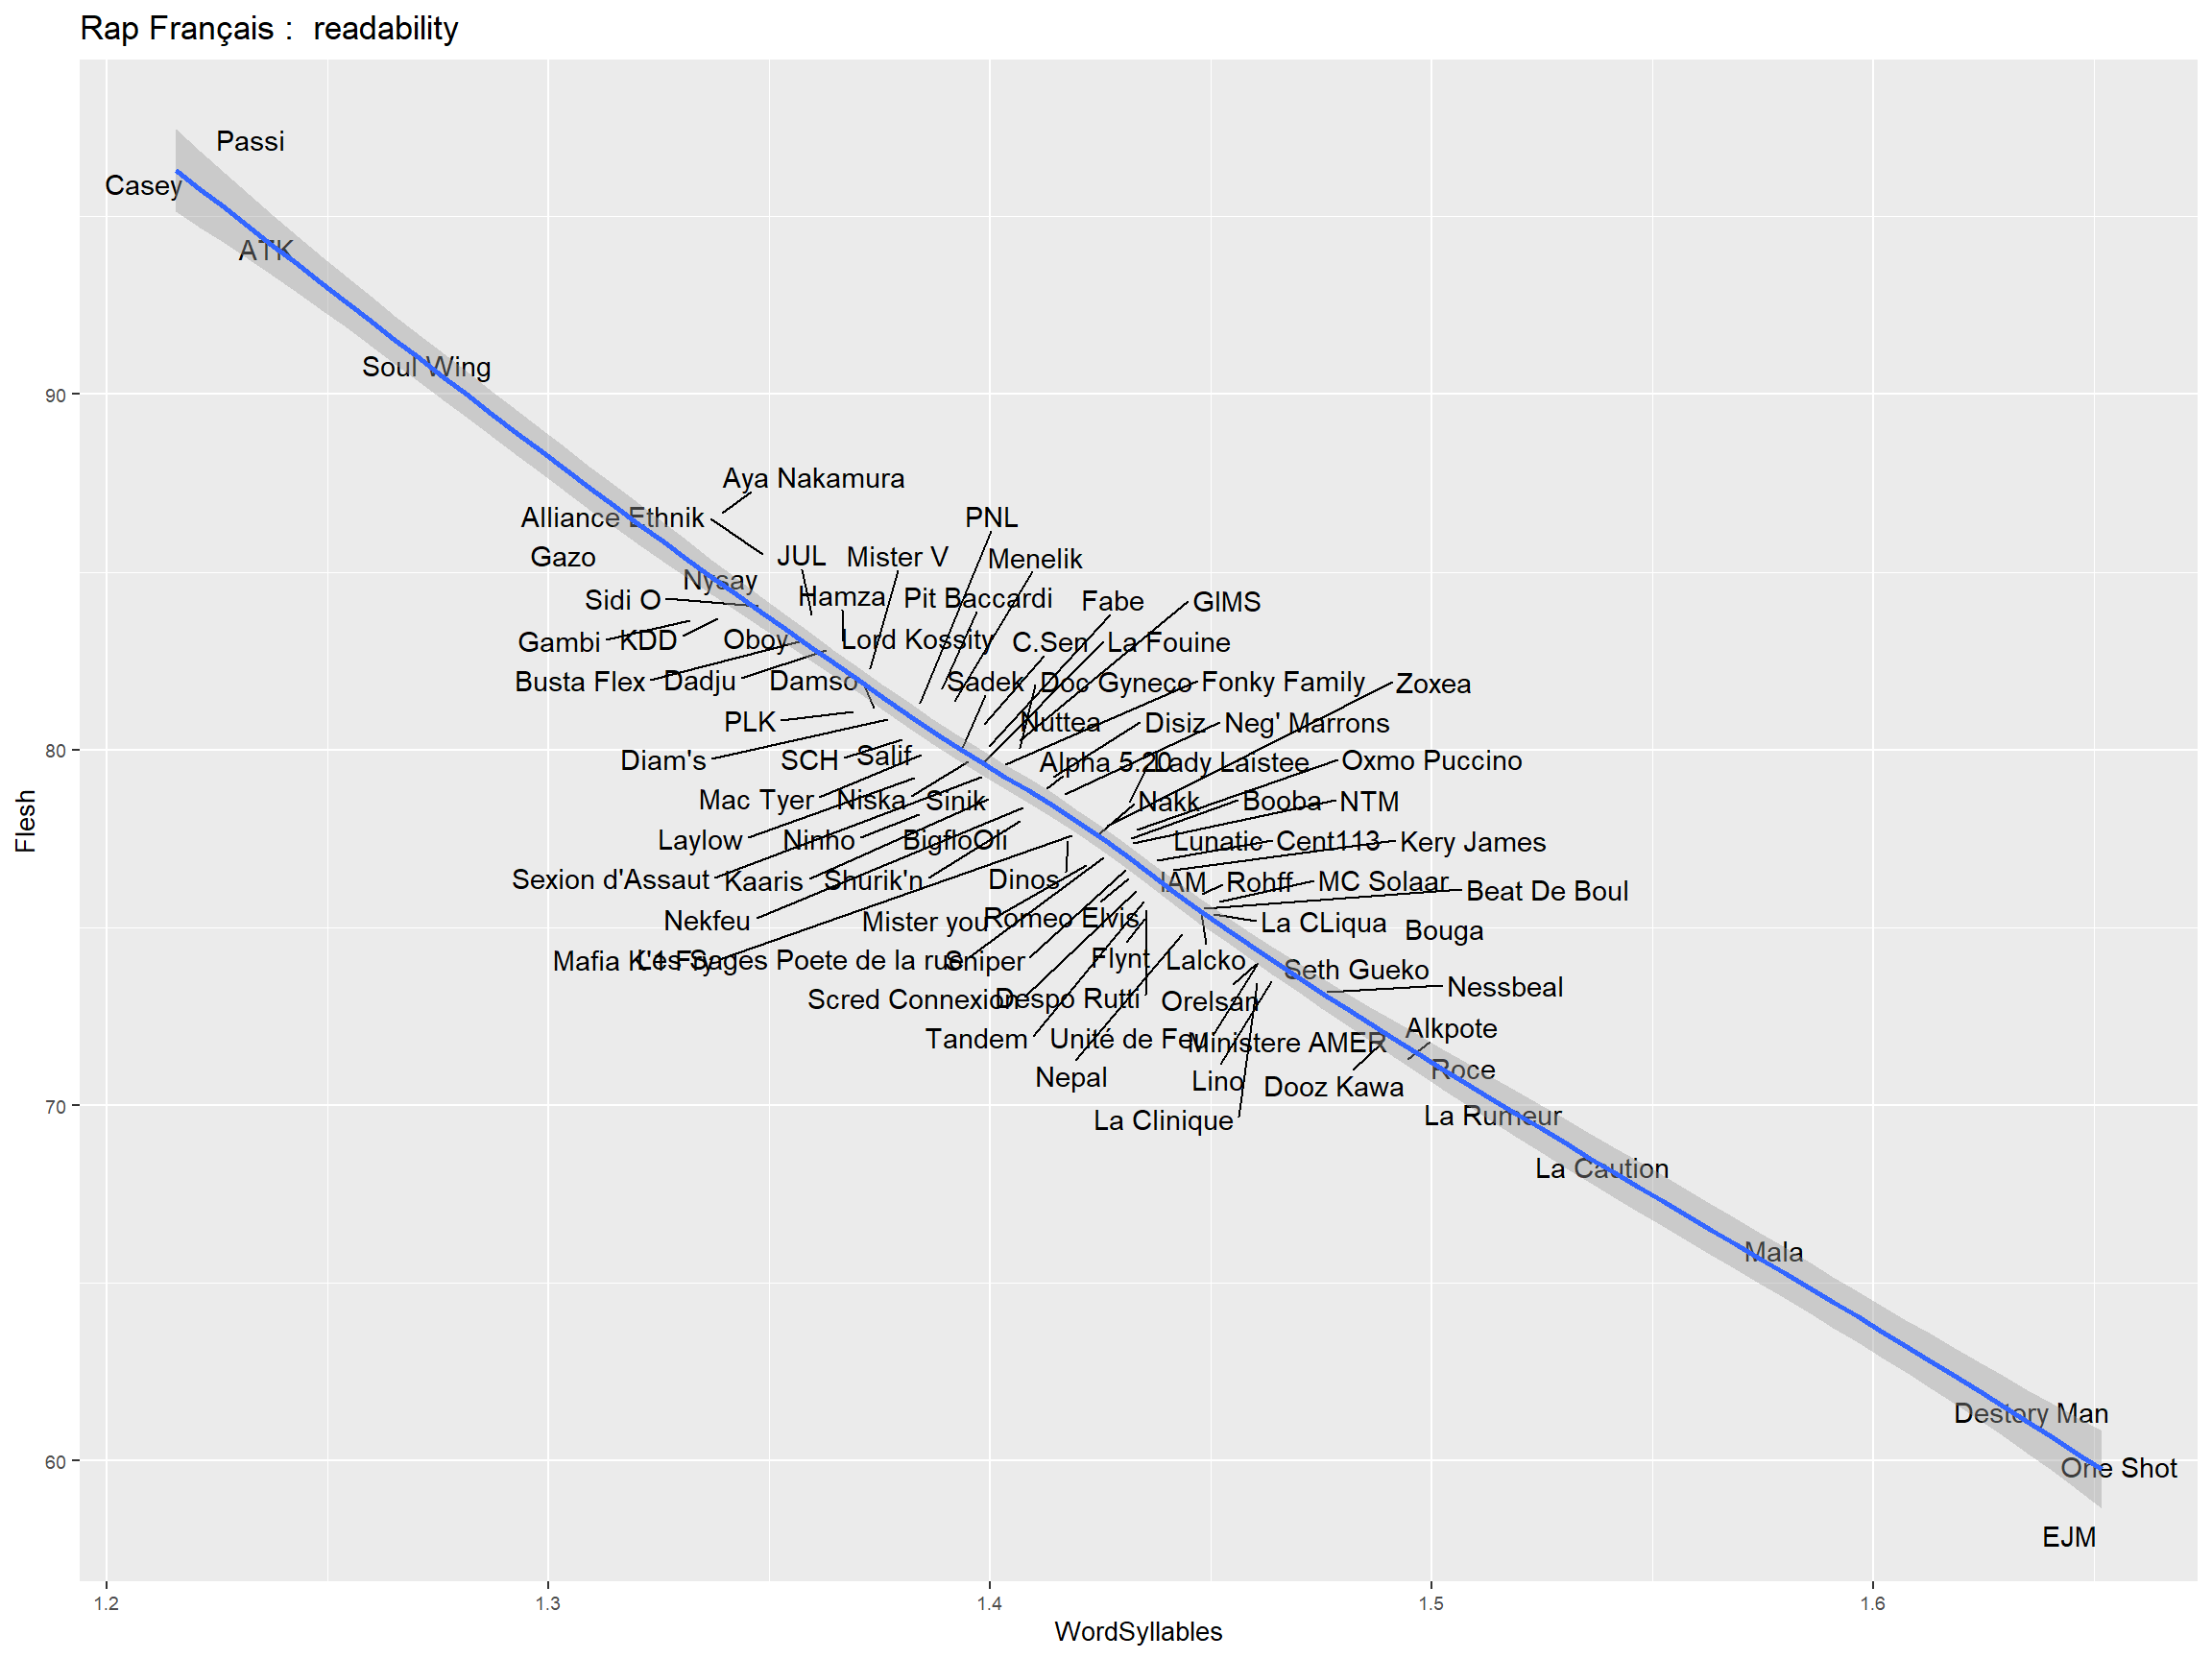
ggplot(foo1,aes(label=Artiste, y=Flesch, x=WordSyllables))+
  geom_text_repel(aes(label=Artiste), max.overlaps =50)+
  labs(title = "Rap Français :  readability", 
       x="WordSyllables", 
       y="Flesh")+ 
  My_Theme+ geom_smooth()+
    scale_size(range = c(.1, 4))

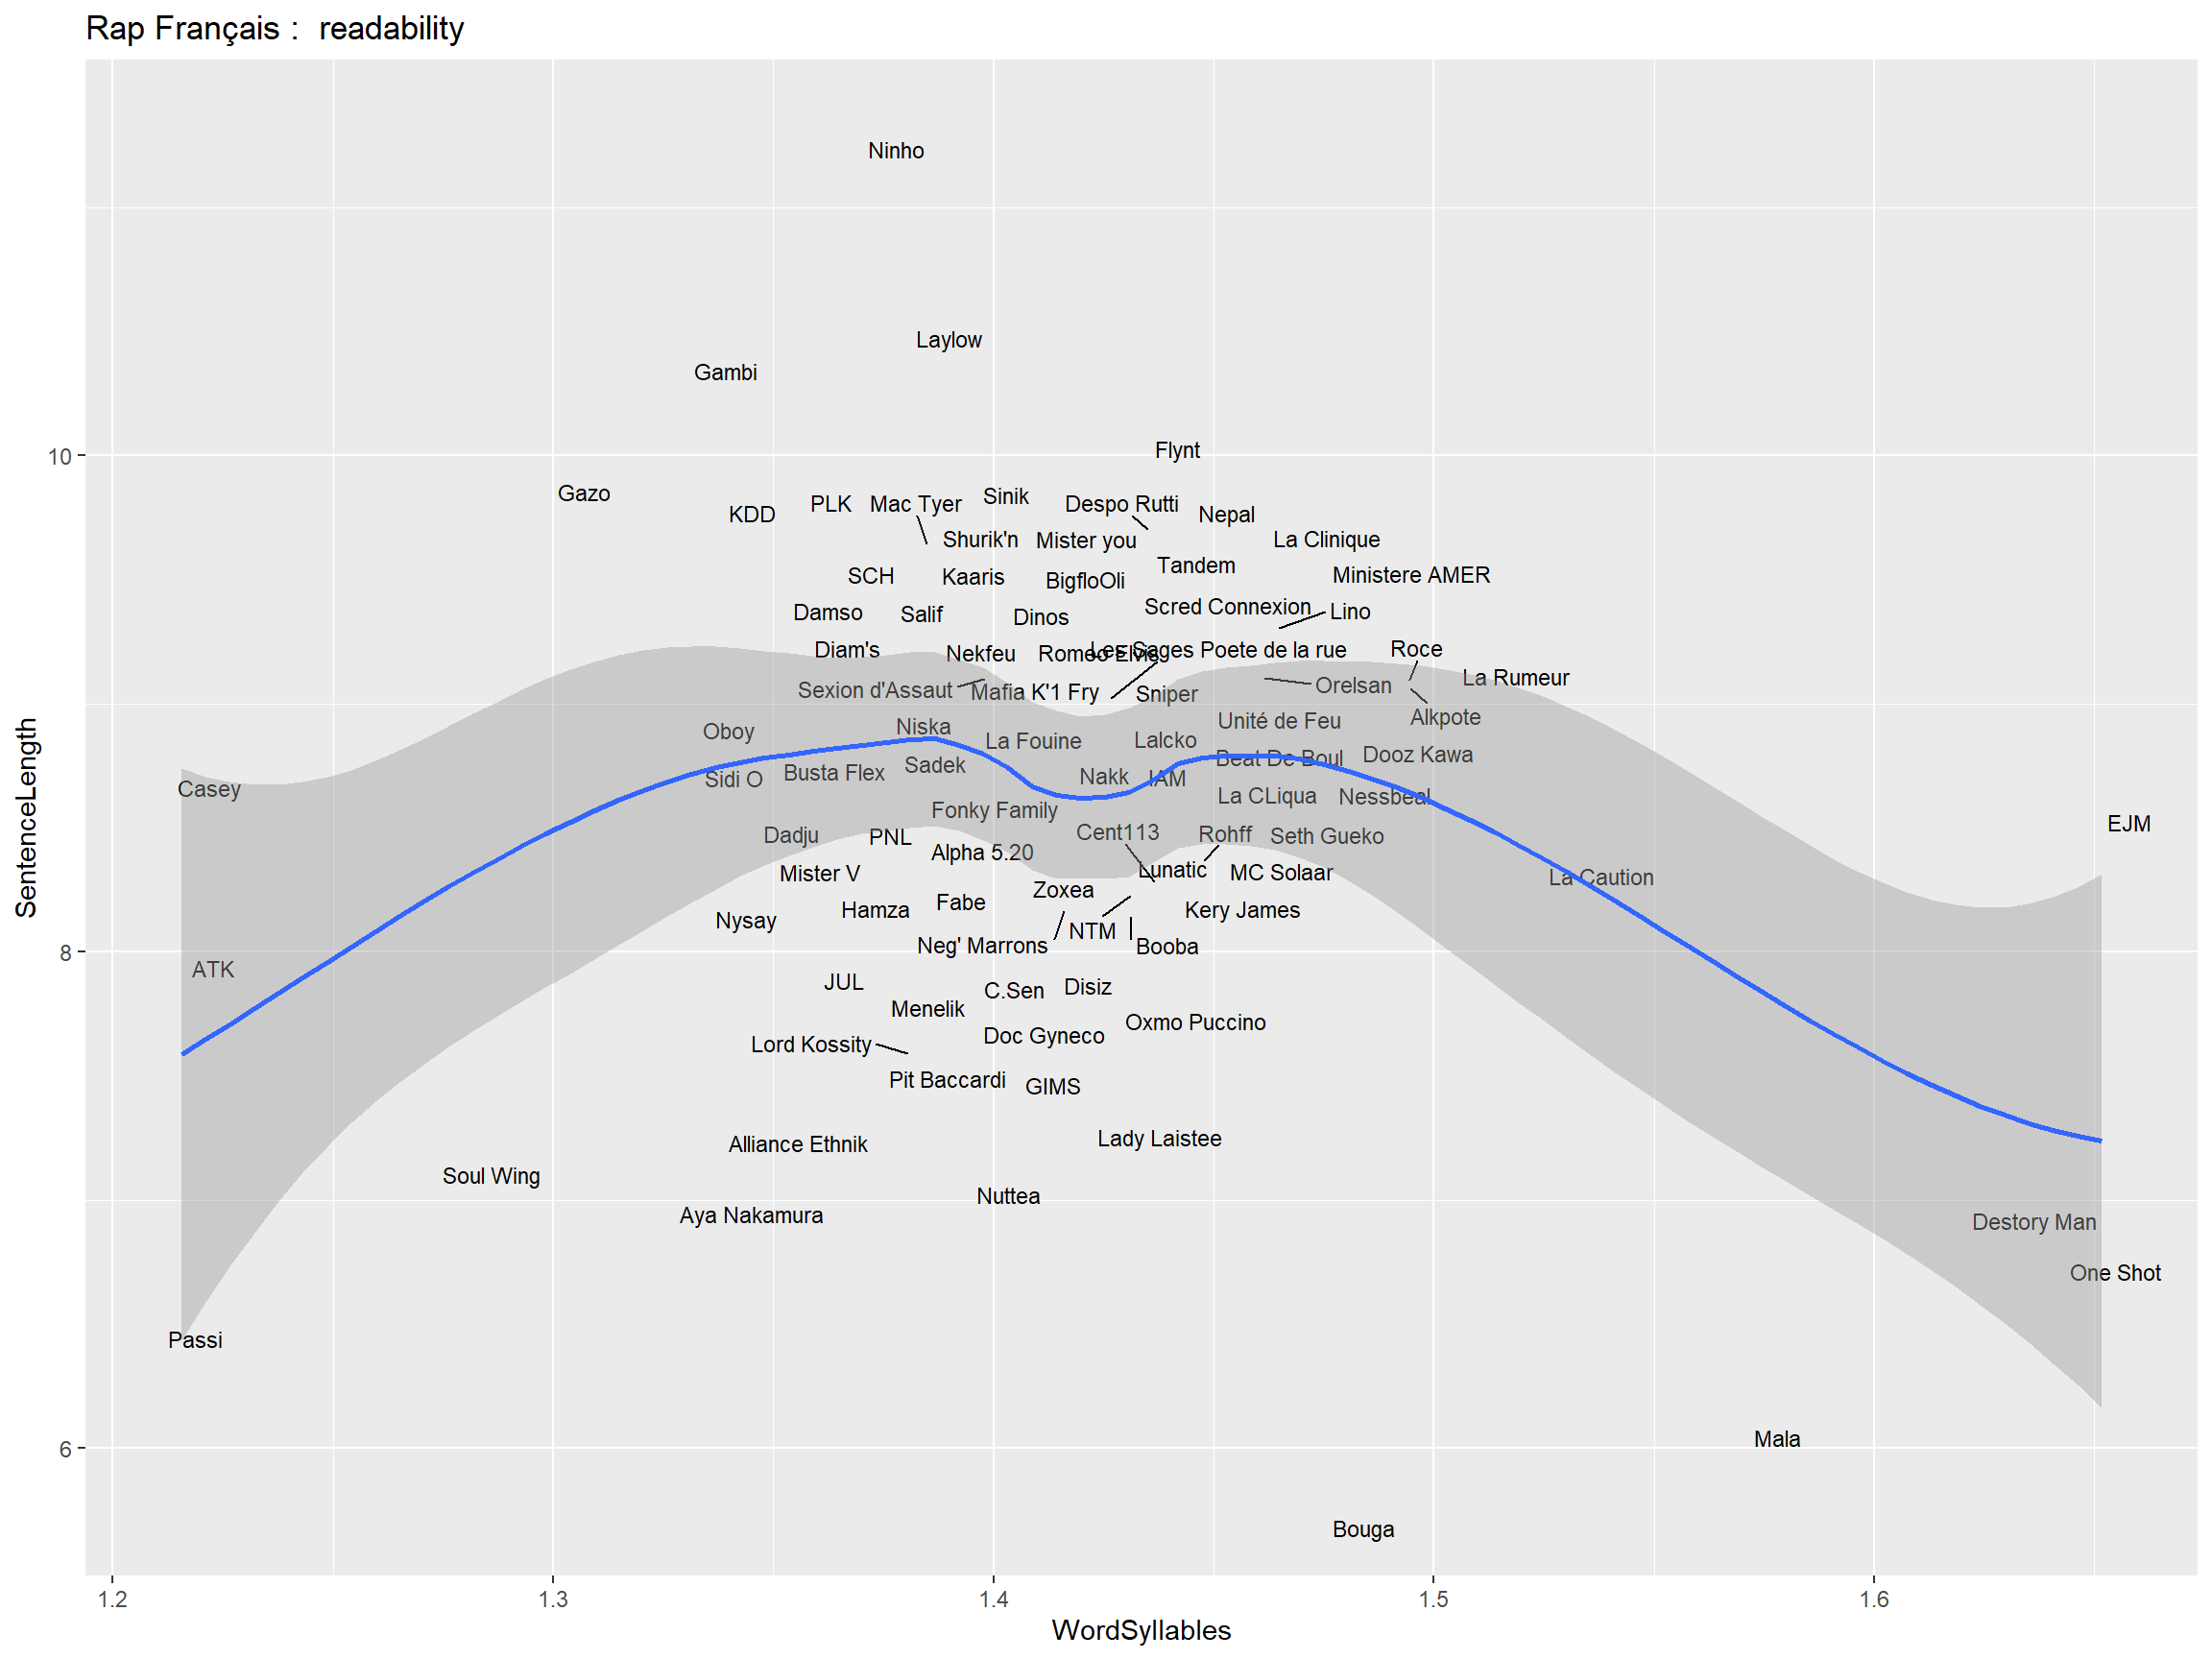
ggplot(foo1,aes(label=Artiste, y=SentenceLength, x=WordSyllables))+
  geom_text_repel(aes(label=Artiste),max.overlaps =50, size=3)+
  labs(title = "Rap Français :  readability", 
       x="WordSyllables", 
       y="SentenceLength")+ 
  geom_smooth()+
    scale_size(range = c(.1, 4))

Diversité lexicale

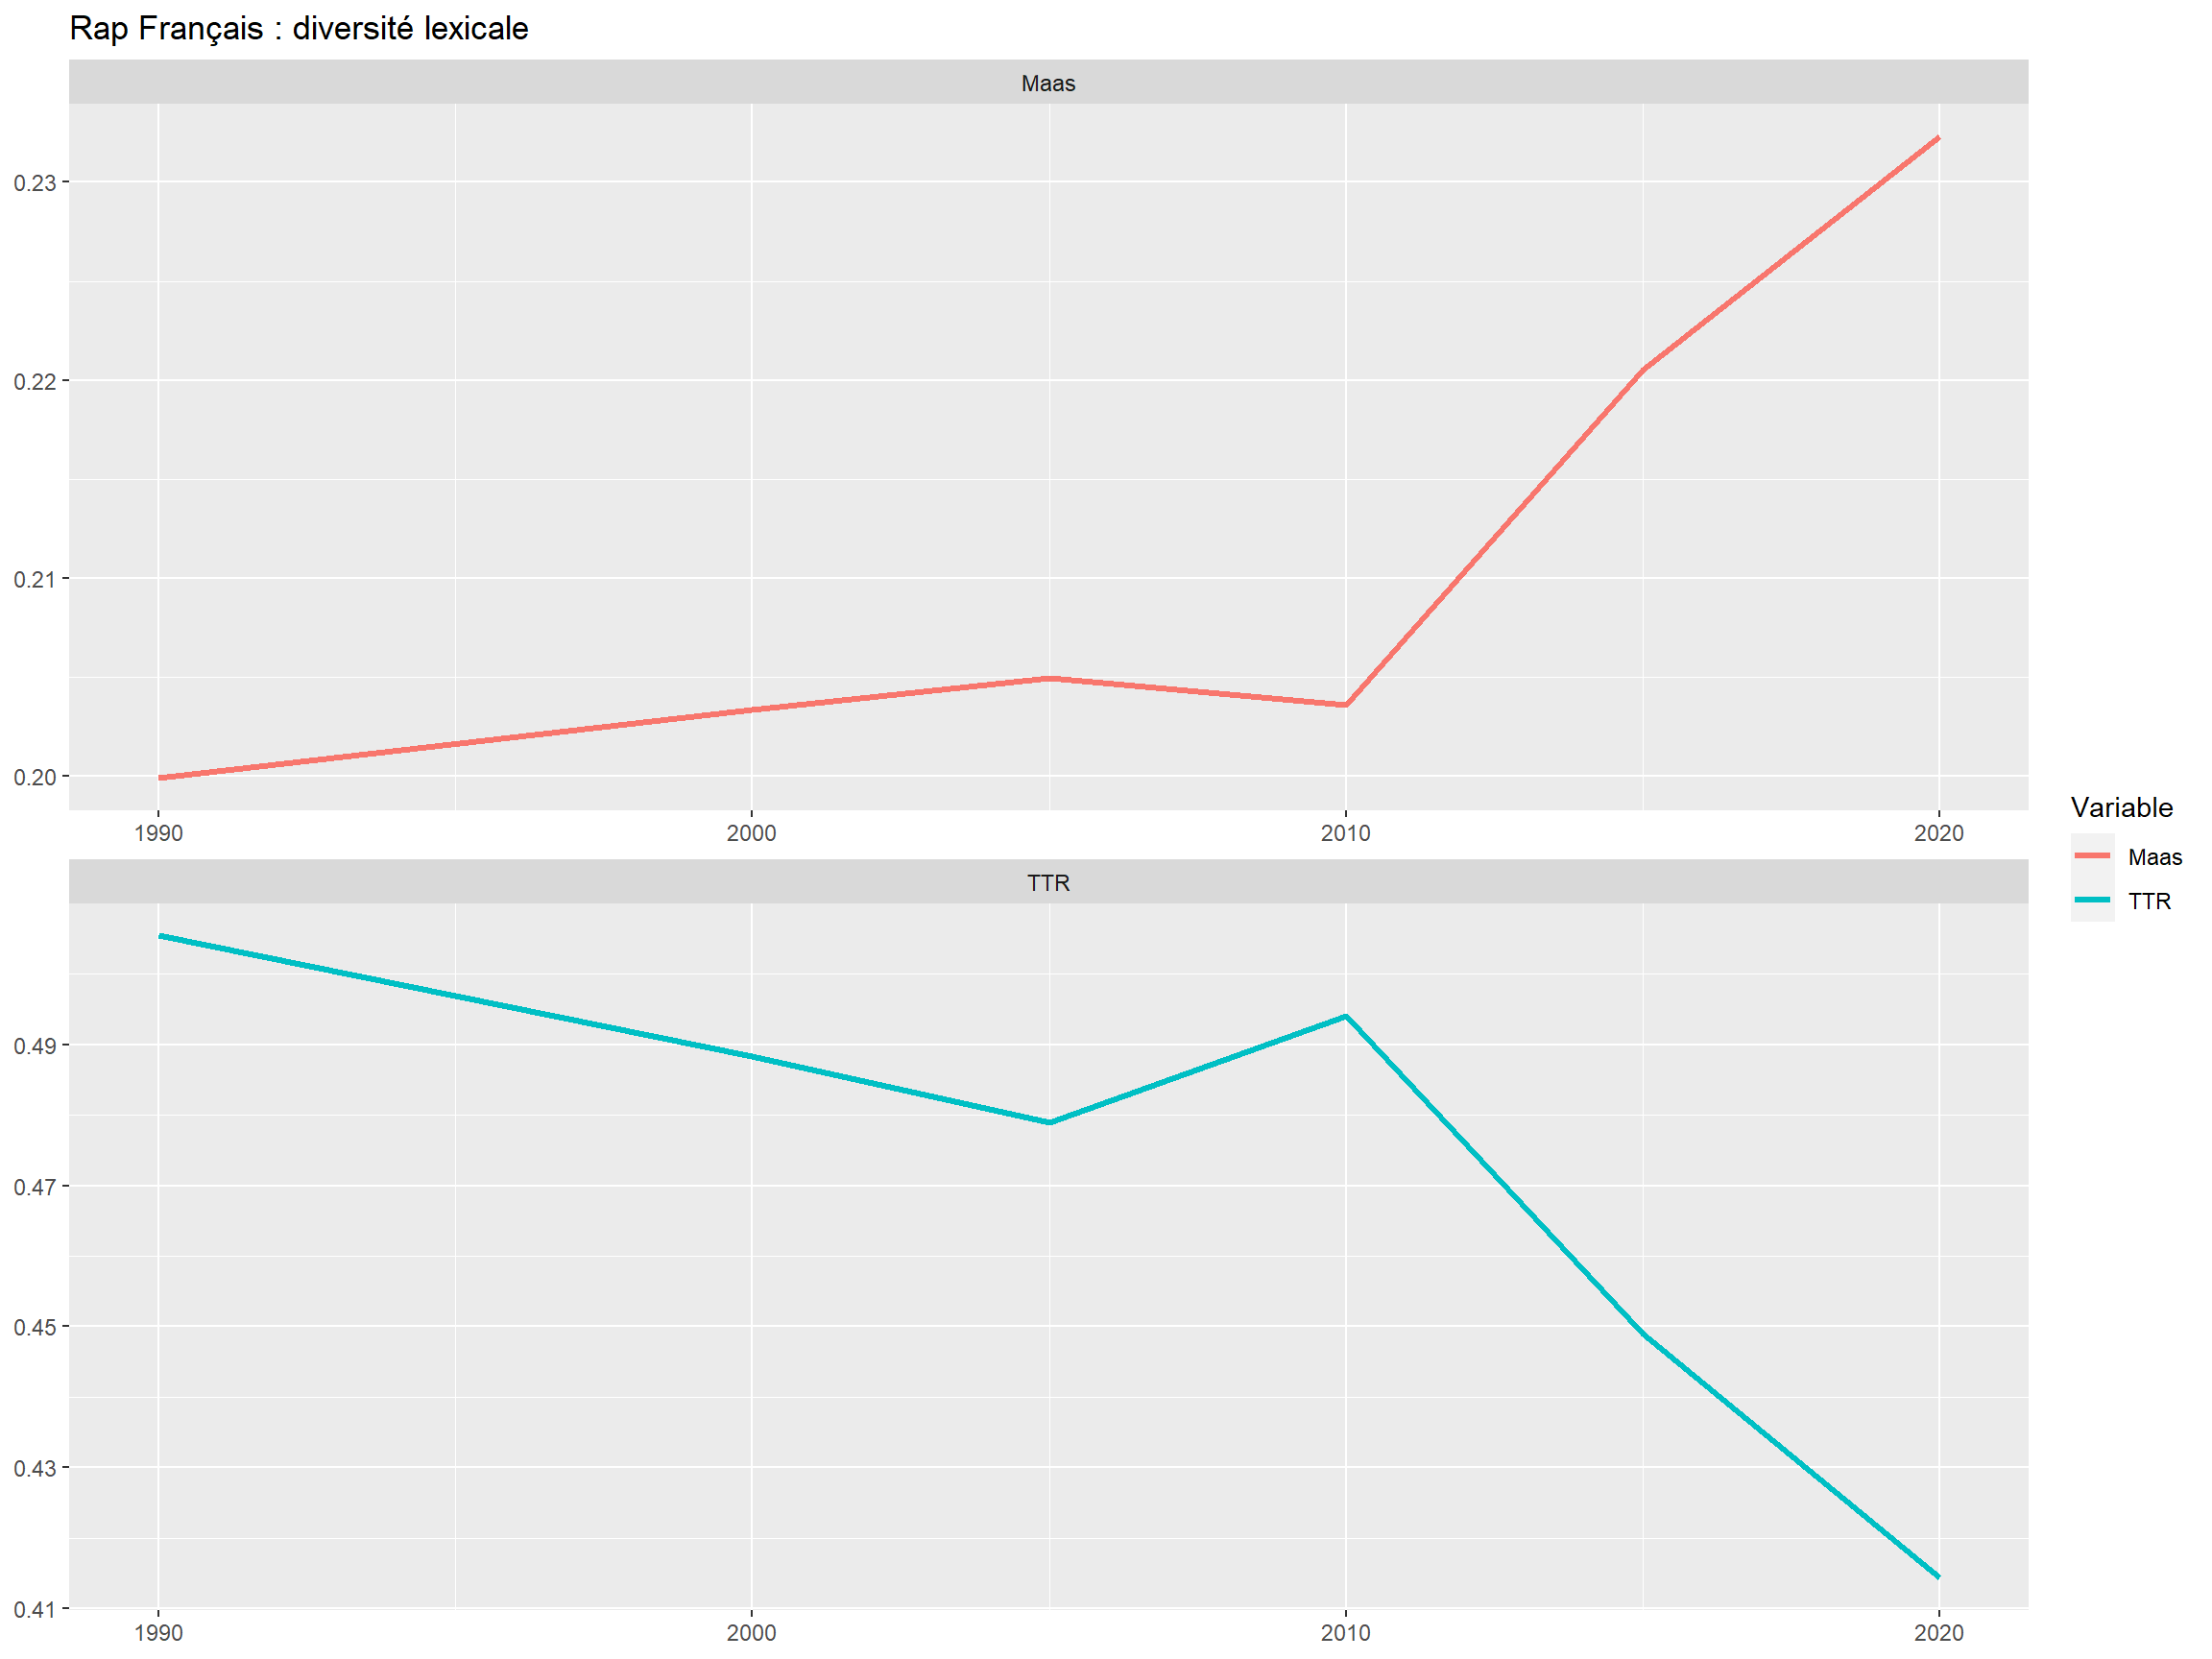
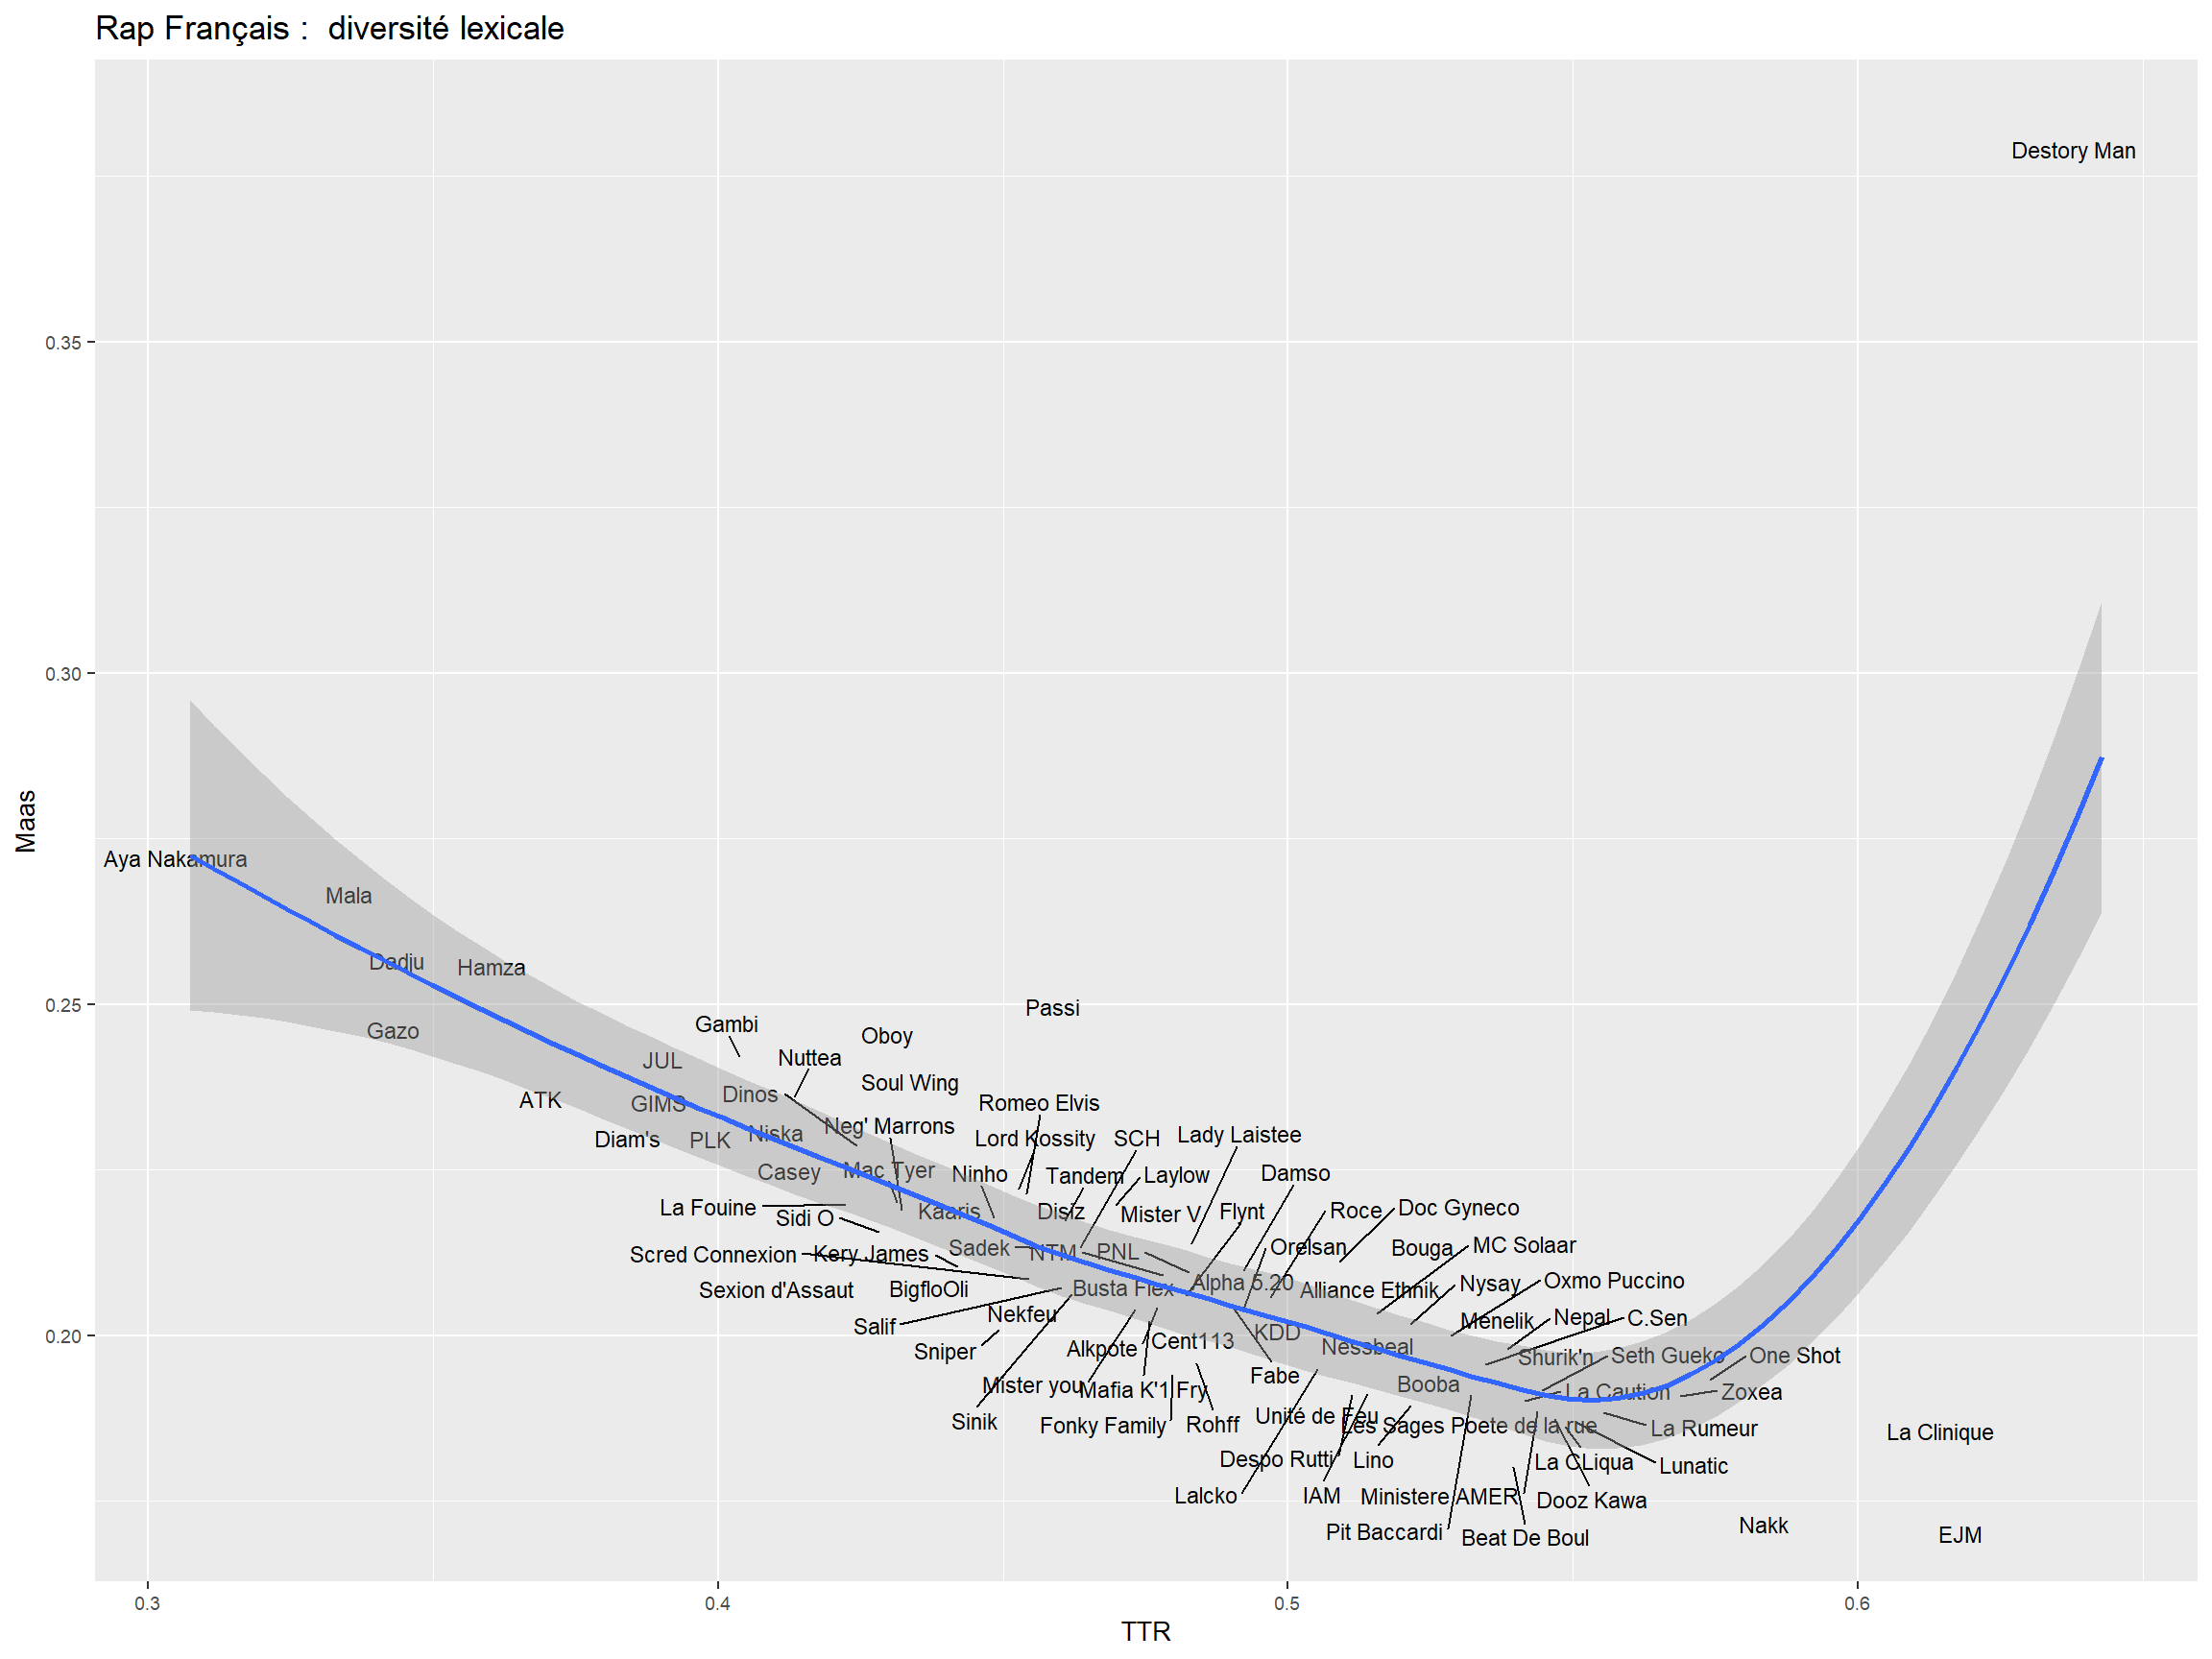
Ce sont les poètes de la rue qui remportent le concours : un [extrait](https://genius.com/Les-sages-poetes-de-la-rue-quest-ce-qui-fait-marcher-les-sages-lyrics), au plus réduit on a [Jul](https://genius.com/Jul-tchikita-lyrics) .

lexdiv<-tokens(text1$Paroles)%>%
  textstat_lexdiv(text1$Paroles, 
                  measure = c("TTR", "Maas"),
                  log.base = 10,
                  remove_numbers = TRUE,  
                  remove_punct = TRUE,  
                  remove_symbols = TRUE,
                  remove_hyphens = TRUE) 

foo<-cbind(text1[,1:10],lexdiv[,2:4])

foo1<-foo %>%
  group_by(quinc) %>%
  summarise(TTR=mean(TTR, na.rm=TRUE), 
            Maas= mean(Maas, na.rm=TRUE)) %>%
  pivot_longer(-quinc,names_to="Variable", values_to="Score")

ggplot(foo1,aes(x=quinc, y=Score, group=Variable))+
  geom_line(size=1.2, aes(color=Variable), stat="identity")+
  facet_wrap(vars(Variable), scale="free", ncol=1)+
  labs(title = "Rap Français : diversité lexicale", x=NULL, y=NULL)

foo1<-foo %>%
  group_by(Artiste) %>%
  summarise(TTR=mean(TTR, na.rm=TRUE), 
            Maas= mean(Maas, na.rm=TRUE))

ggplot(foo1,aes(label=Artiste, x=TTR, y=Maas))+
  geom_text_repel(aes(label=Artiste), stat="identity", size=3, max.overlaps =30)+
  labs(title = "Rap Français :  diversité lexicale", x="TTR", y="Maas")+ My_Theme+geom_smooth()

Sentiment

Sentiment et émotions

library(syuzhet)

#paramétres
method <- "nrc"
lang <- "french"

#extraction
emotions <- get_nrc_sentiment(text1$Paroles,language = "french")
polarity<-subset(emotions,select=c(positive, negative))
foo<-cbind(text1,polarity)

#mean per 
foo1<-foo %>%
  mutate(positive=positive/n_words, 
         negative=negative/n_words,
         neutral=1- positive-negative)%>%
  group_by(quinc) %>%
  summarise(positive=mean(positive, na.rm=TRUE), 
            negative= -mean(negative, na.rm=TRUE))%>%
  pivot_longer(-quinc,names_to="Variable", values_to="Score")

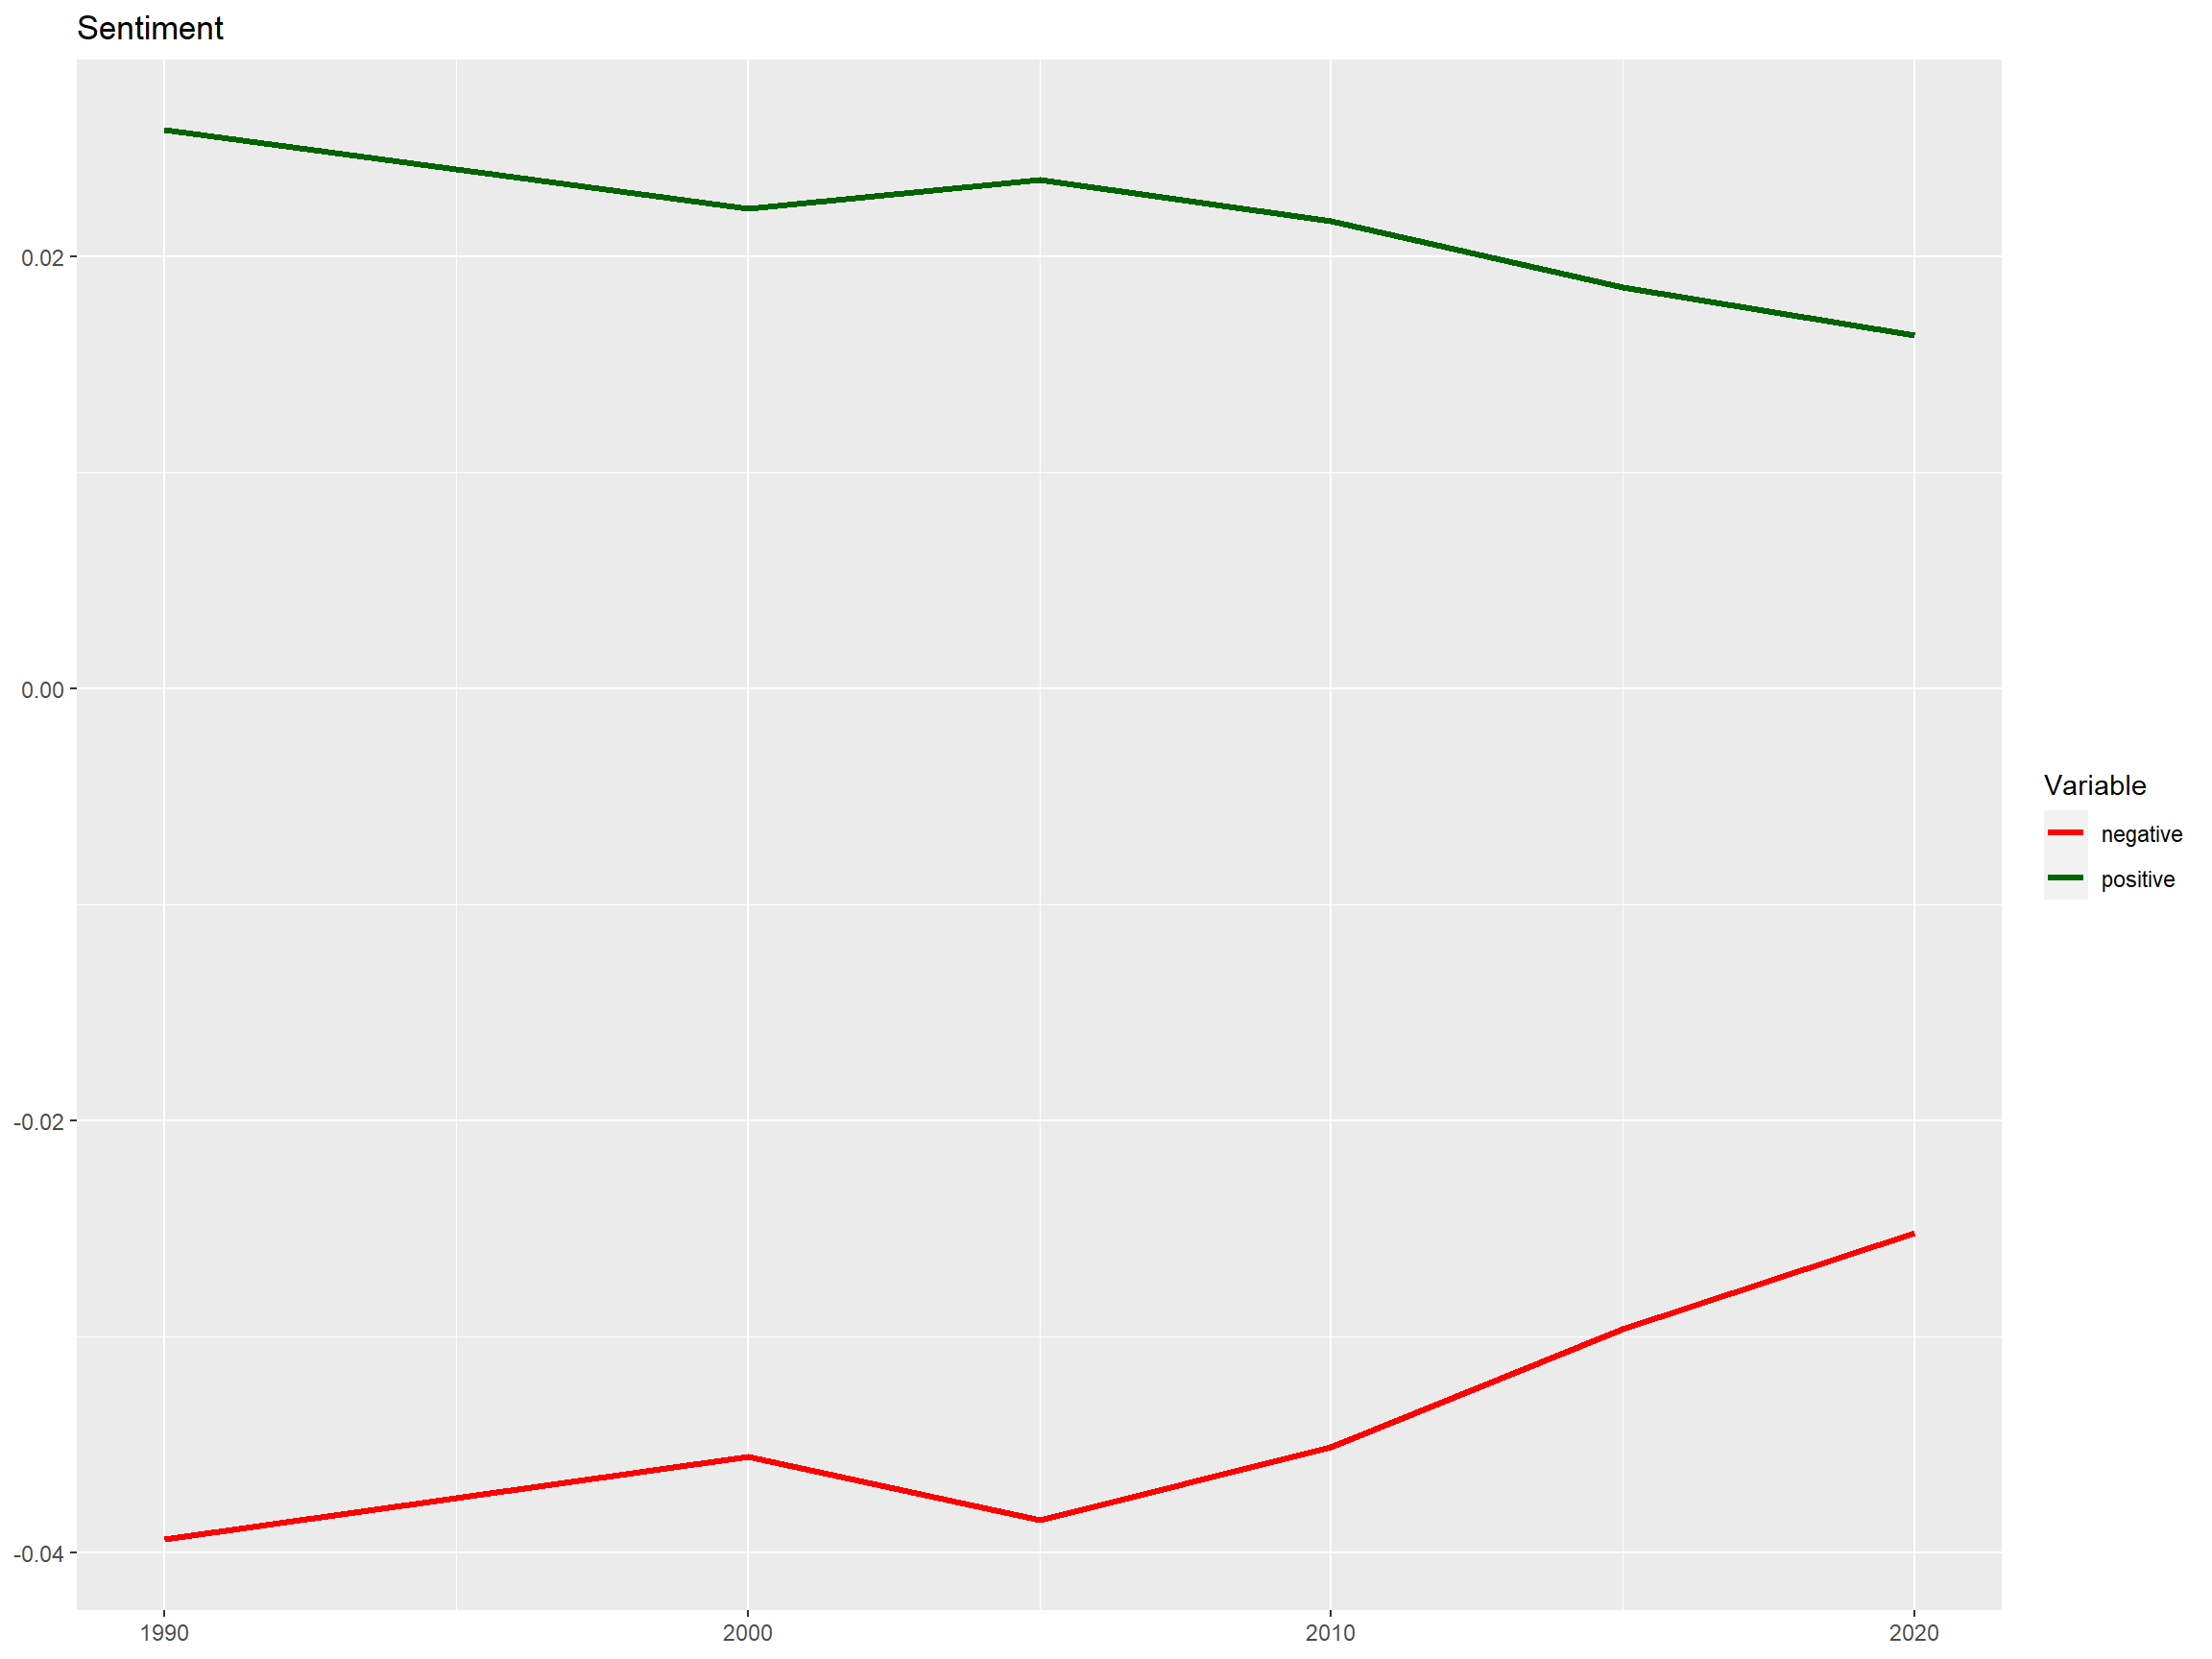
ggplot(foo1,aes(x=quinc, y=Score, group=Variable))+
  geom_line(size=1.2, aes(color=Variable), stat="identity")+
  labs(title = "Sentiment", x=NULL, y=NULL)+
  scale_colour_manual(values=c( "Red", "Darkgreen"))

emotion<-emotions[,1:8]
foo<-cbind(text1,emotion)

foo1<-foo %>%
  mutate(anger=anger/n_words, 
         joy=joy/n_words,
         sadness= sadness/n_words,
         surprise=surprise/n_words,
         fear=fear/n_words)%>%
  group_by(quinc) %>%
  summarise(anger=mean(anger, na.rm=TRUE), 
            joy= mean(joy, na.rm=TRUE),
            sadness=mean(sadness, na.rm=TRUE),
            surprise=mean(surprise, na.rm=TRUE),
            fear=mean(fear, na.rm=TRUE)
            )%>%
  pivot_longer(-quinc,names_to="Variable", values_to="Score")


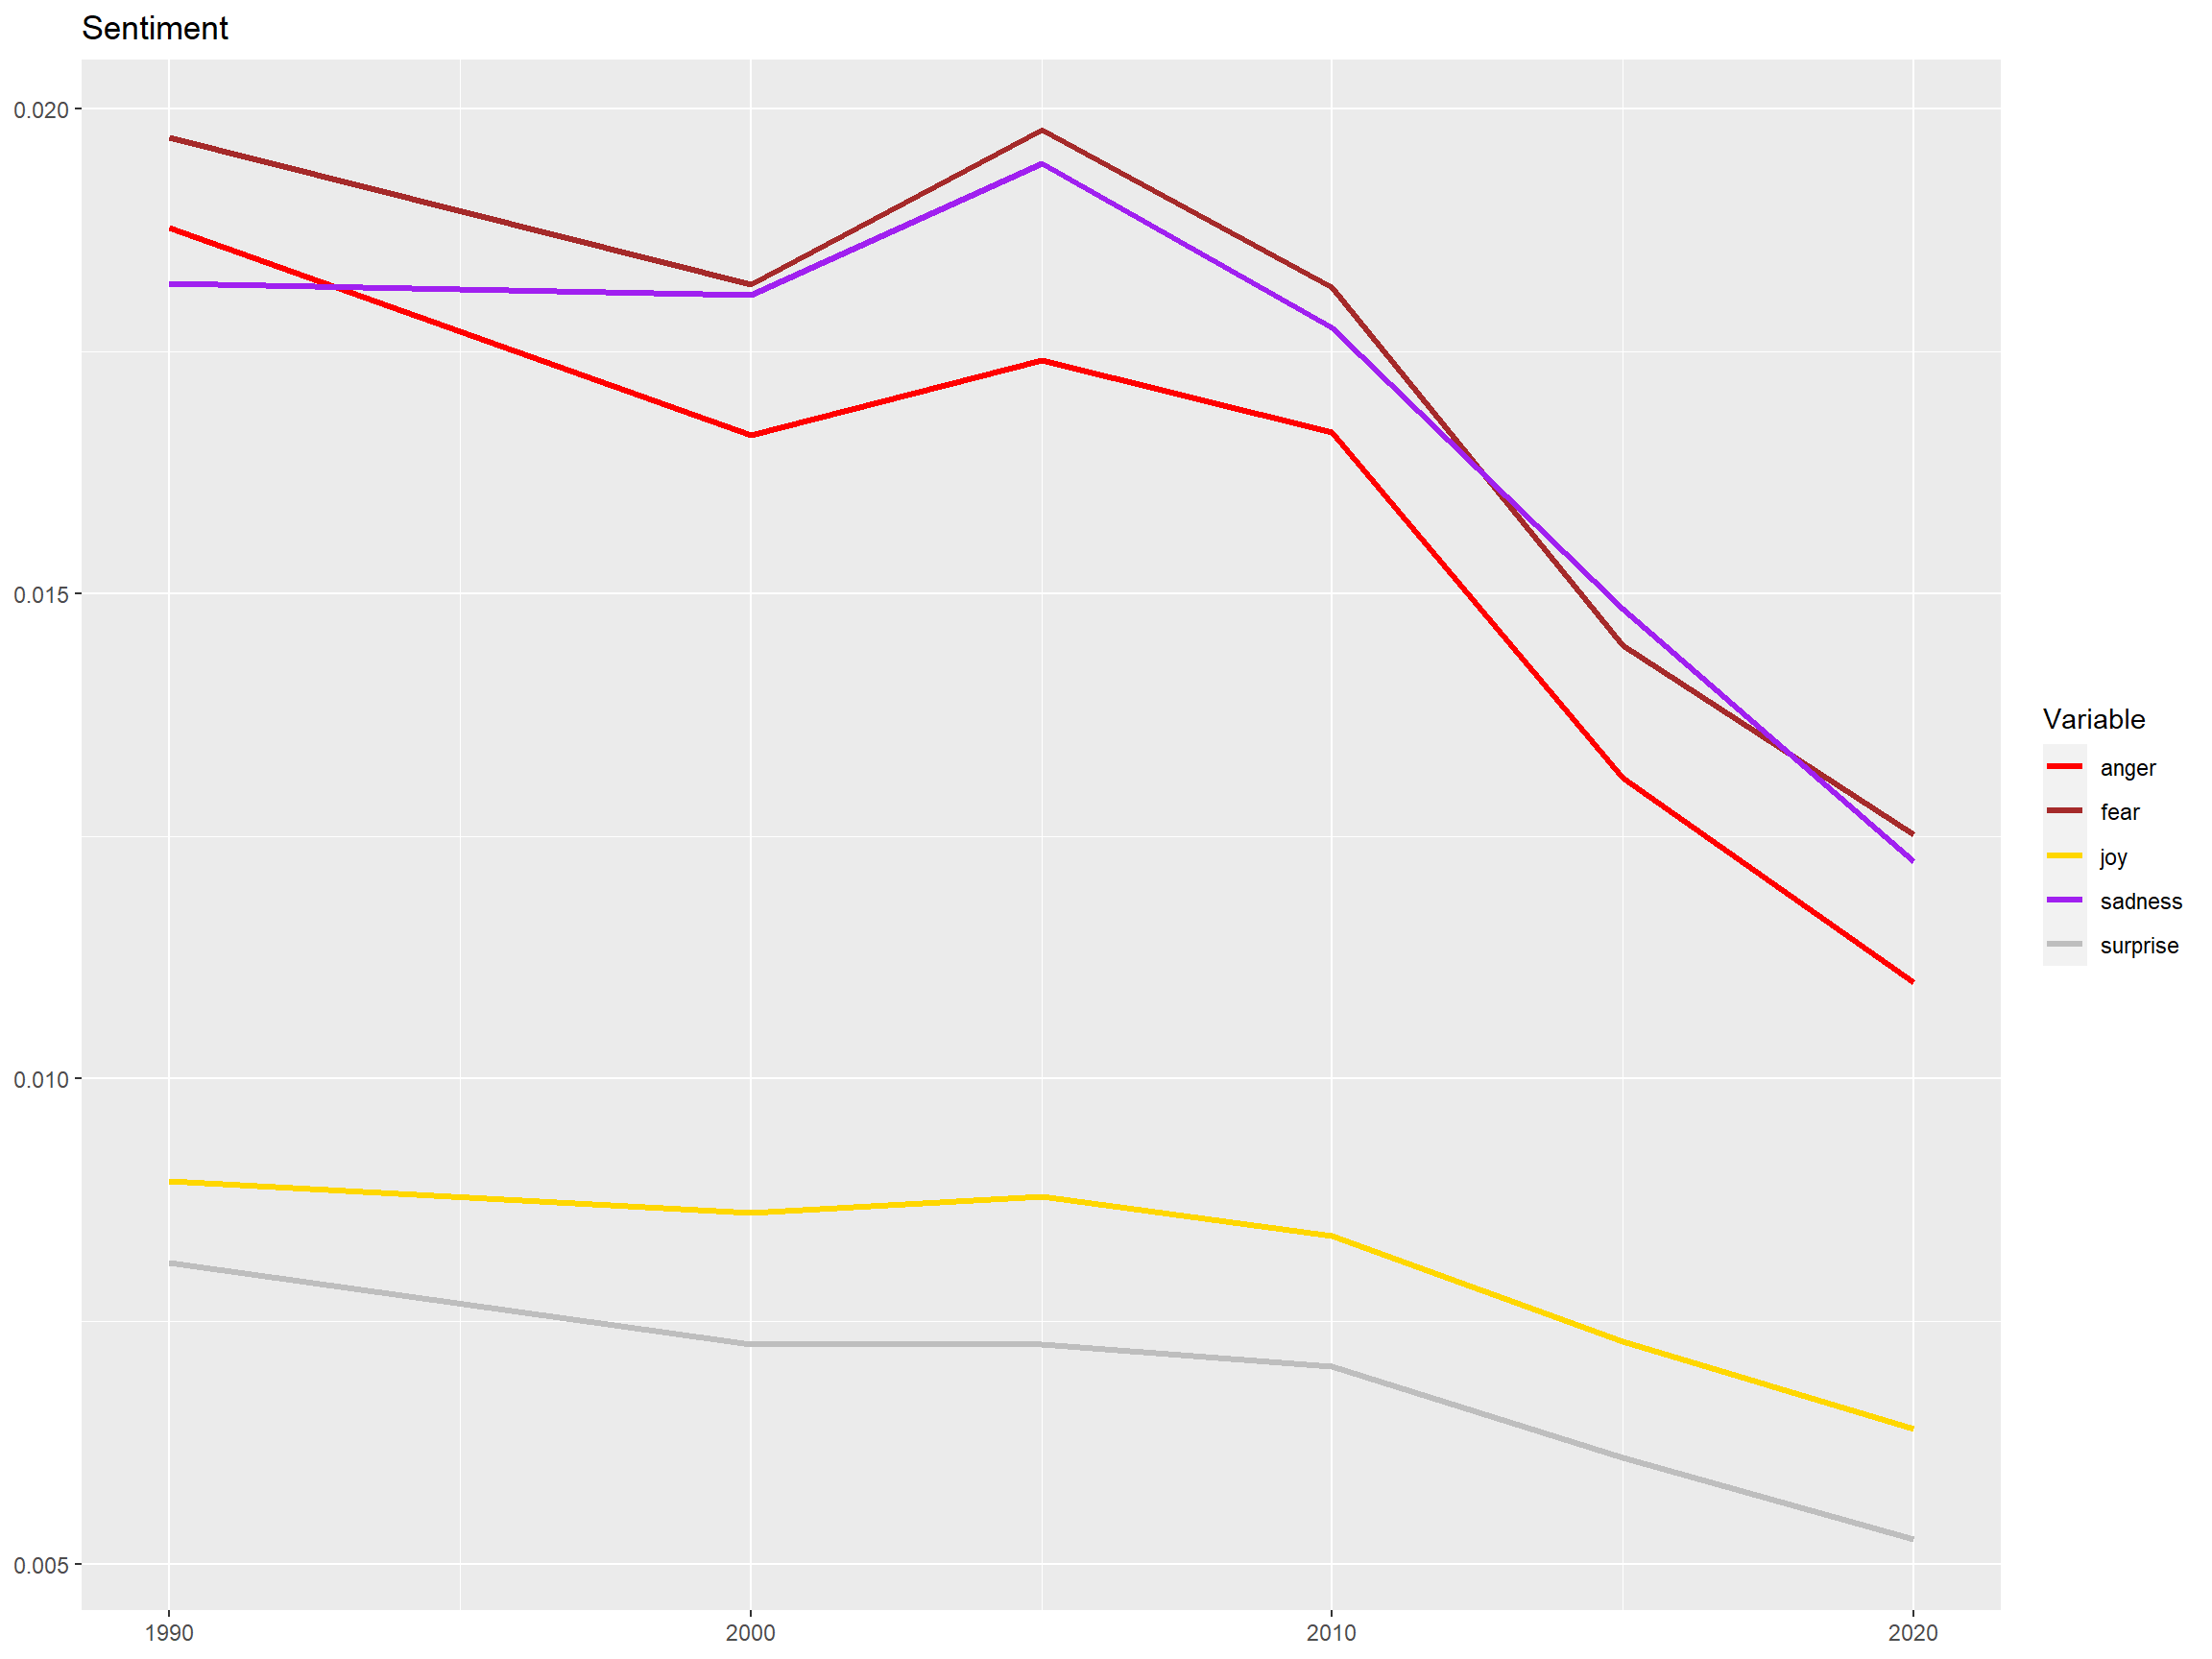
ggplot(foo1,aes(x=quinc, y=Score, group=Variable))+
  geom_line(size=1.2, aes(color=Variable), stat="identity")+
  labs(title = "Sentiment", x=NULL, y=NULL)+
  scale_colour_manual(values=c( "Red", "Brown", "Gold", "Purple", "Grey"))

Sexe, et sexisme

my_text <- text1$Paroles
method <- "custom"
lexicon_sexisme<- data.frame(word=c("Put","put","Pute","pute", "putes",
                                    "pu-pu-pu-pute", "Conne", "conne",
                                    "Putain", "putain", "putaine",
                                    "salope", "salopes", "Salope", "Salopes", 
                                    "Pétasse", "pétasse","pétasses",
                                    "morue","Chienne, chienne","chiennes",
                                    "bitch","bitches","bitchs",
                                    "femelle", "femelles", "pédé",
                                    "escorte", "garce","pédés",
                                    "prostipute"
                                    ),
                             value=c(1,1,1,1,1,1,1,1,1,1,
                                     1,1,1,1,1,1,1,1,1,1,
                                     1,1,1,1,1,1,1,1,1,1,
                                     1))

custom_sexisme <- get_sentiment(my_text, 
                                method = method, 
                                lexicon = lexicon_sexisme)

custom_sexisme<-as.data.frame(custom_sexisme)


lexicon_sexe <- data.frame(word=c("bite","bites", "Chatte","chatte","chattes",
                                  "queue","suce", "sucer","Suce",
                                  "Baiser", "baiser","baise","baises",
                                  "foutre", "niquer","nique","Nique","Niquer",
                                  "couille", "couilles", "fuck","Fuck",
                                  "hmm", "sein","seins",
                                  "enculé", "enculés", "enculer", "Enculé",
                                  "Enculés", "Enculer", "violer",
                                  "sex", "sexe", "sperme","cul", "mouille", "zob"),
                             value=c(1,1,1,1,1,1,1,1,1,1,
                                     1,1,1,1,1,1,1,1,1,1,
                                     1,1,1,1,1,1,1,1,1,1,
                                     1,1,1,1,1,1,1,1))
custom_sexe <- get_sentiment(my_text, 
                                method = method, 
                                lexicon = lexicon_sexe)


custom_sexe<-as.data.frame(custom_sexe)

foo<-cbind(text1,custom_sexisme,custom_sexe)%>%
  mutate(tx_sexisme=custom_sexisme/n_words,
         tx_sexe=custom_sexe/n_words)

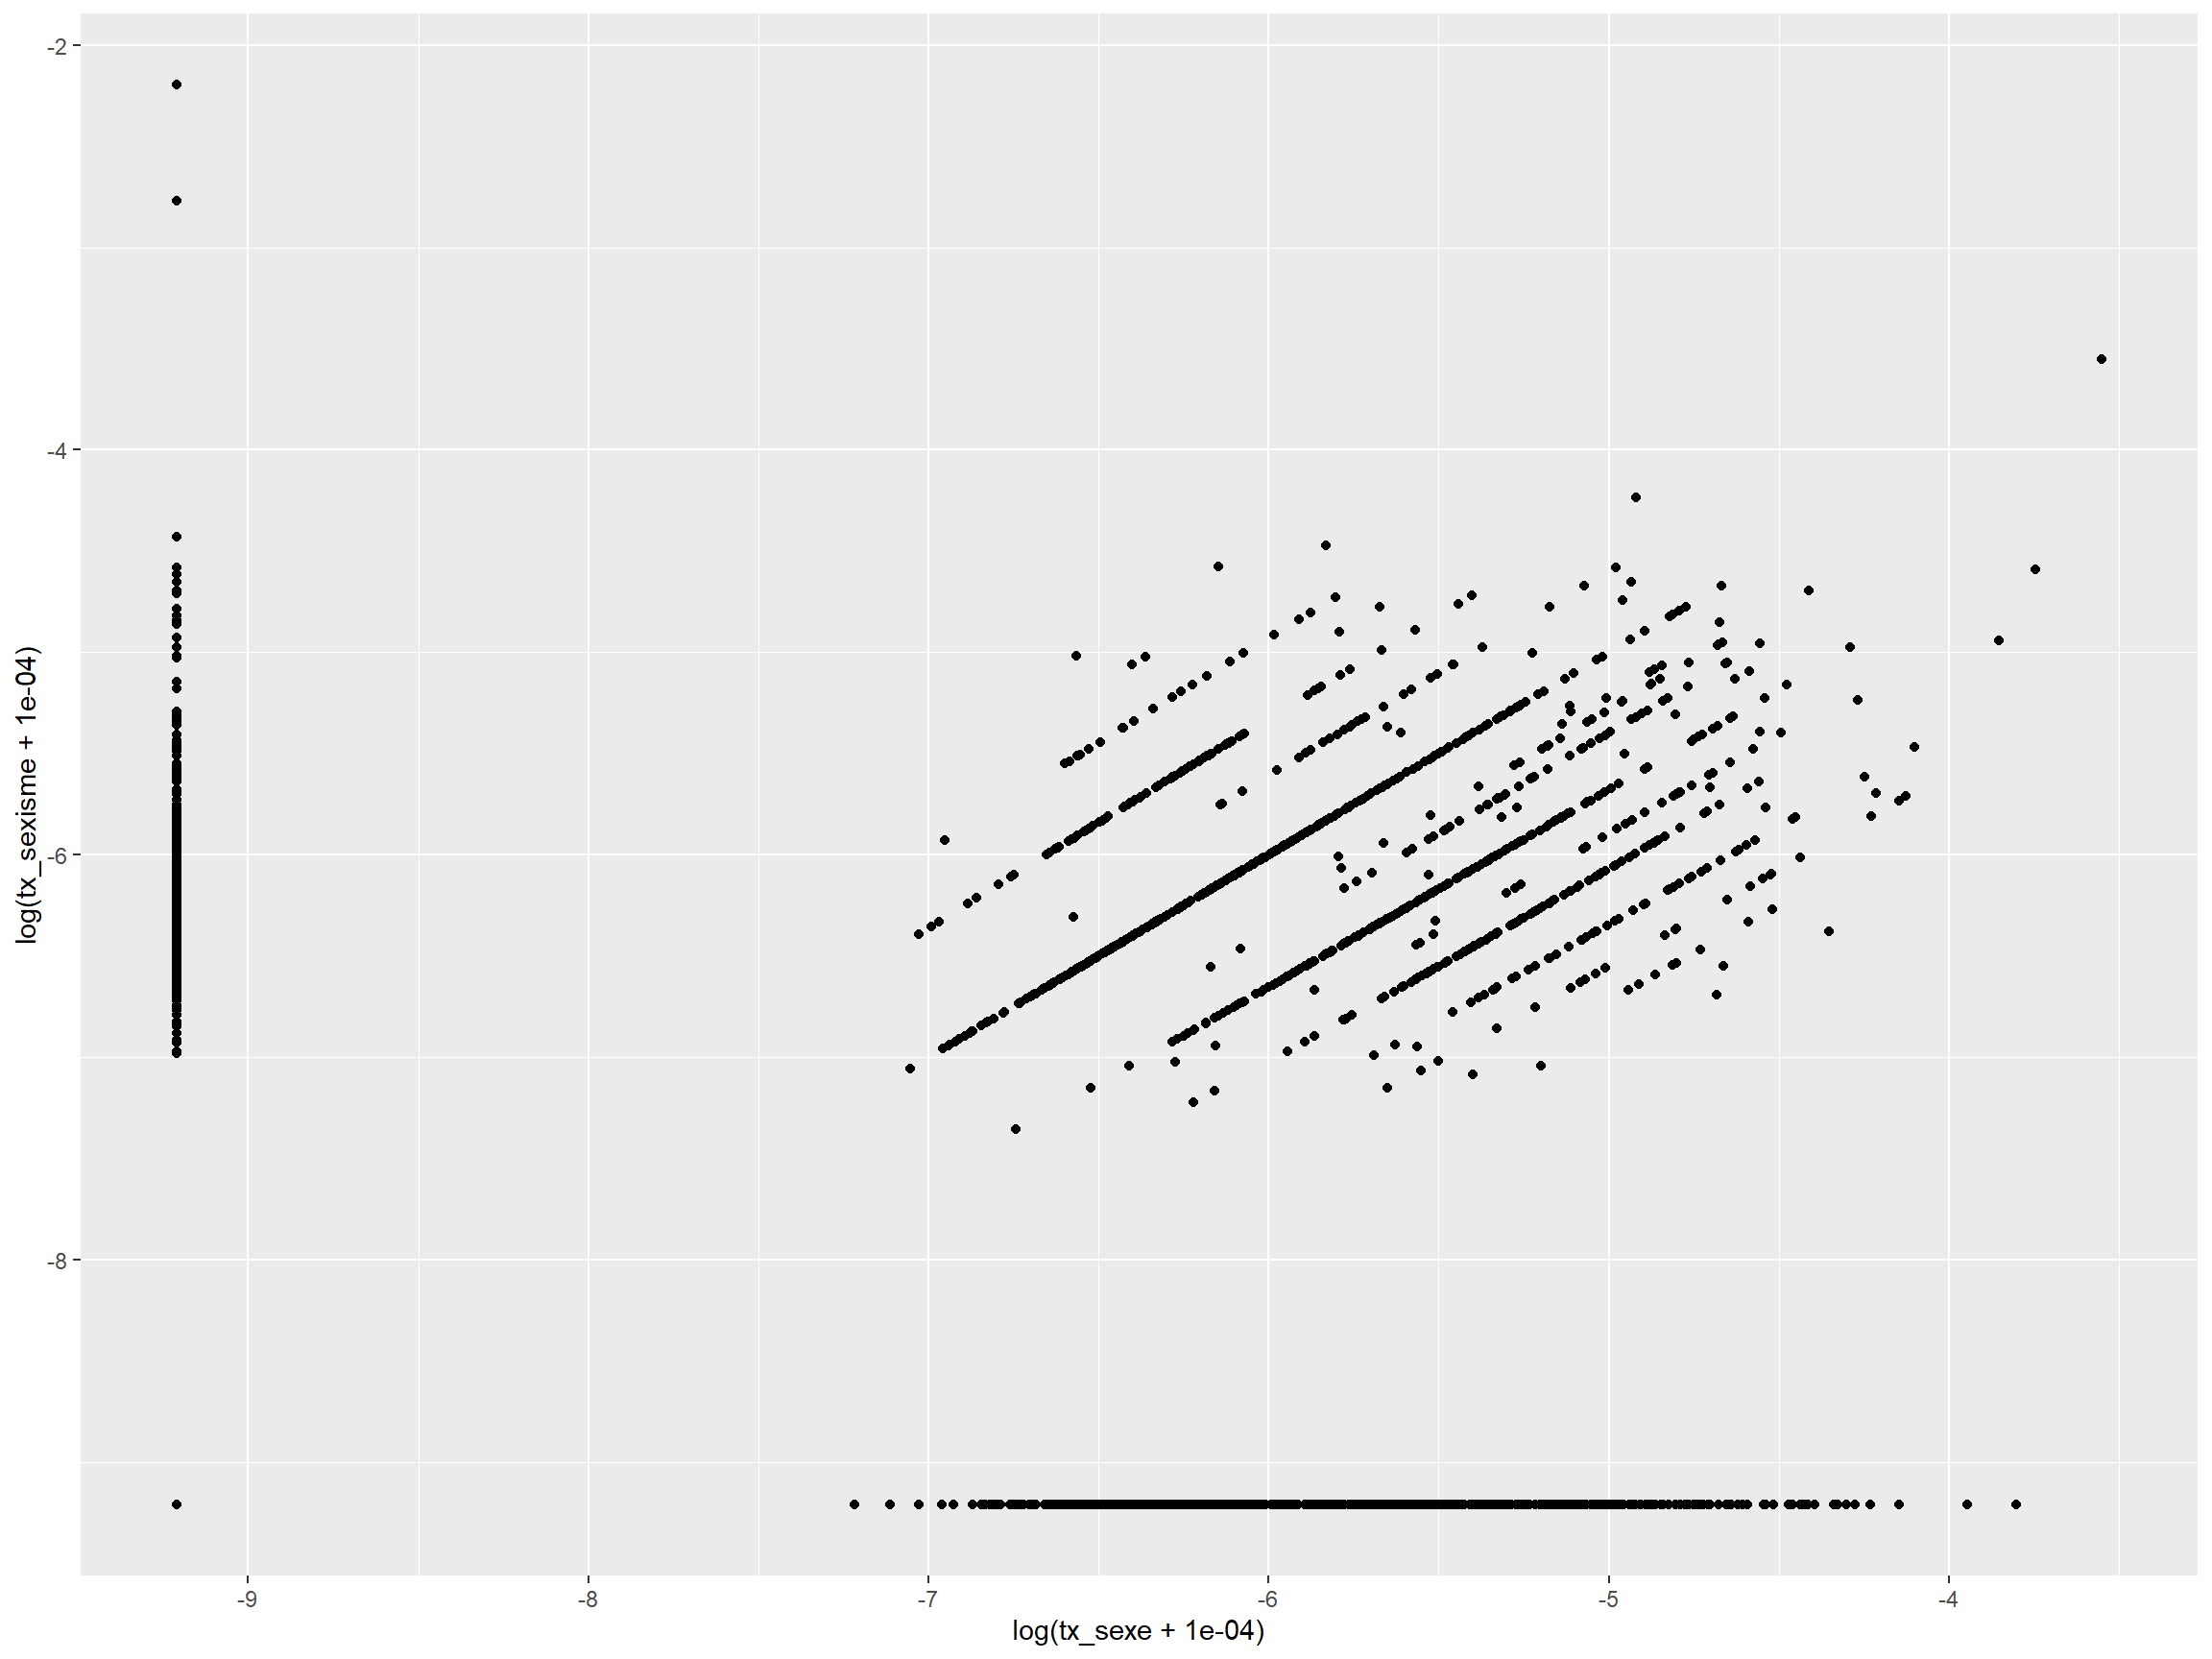
ggplot(foo, aes(x=log(tx_sexe+0.0001), y=log(tx_sexisme+0.0001)))+
  geom_jitter(position = "jitter")

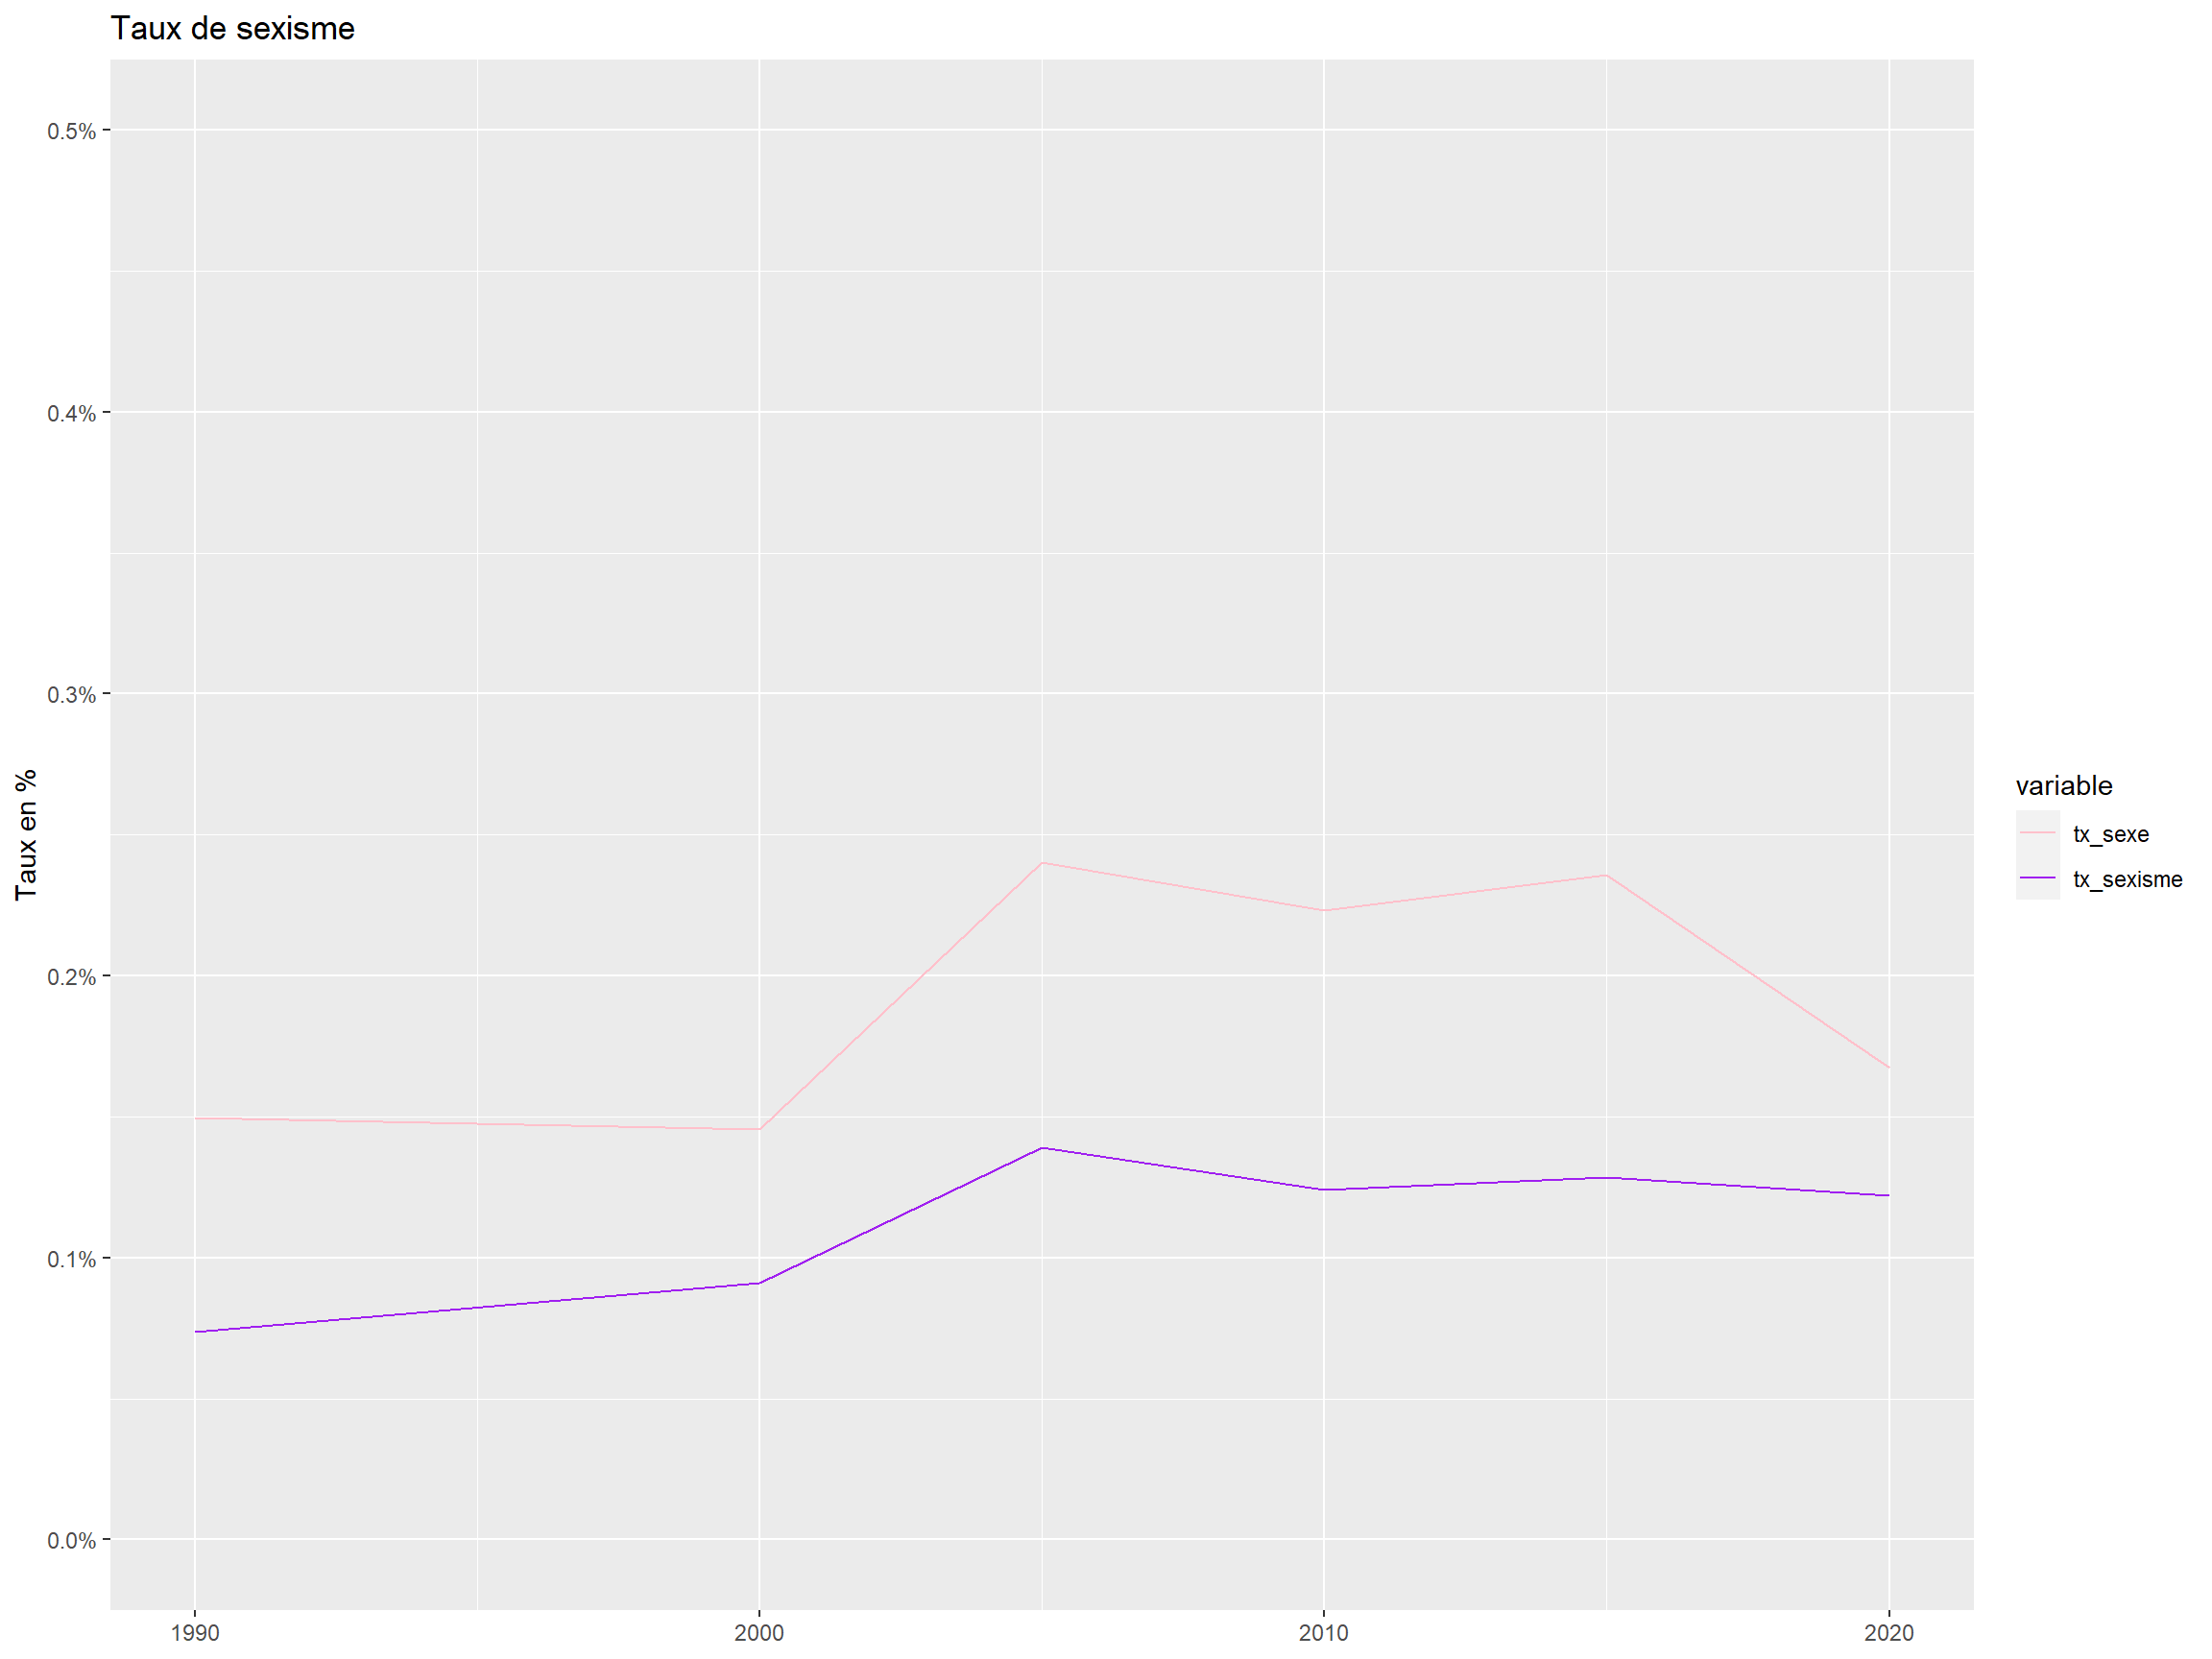
foo1<-foo %>%
  group_by(quinc) %>%
  summarise(tx_sexisme=mean(tx_sexisme, na.rm=TRUE),
            tx_sexe=mean(tx_sexe, na.rm=TRUE))%>%
  pivot_longer(-quinc,names_to="variable", values_to='value')

ggplot(foo1,aes(x=quinc, y=value, group=variable))+
  geom_line(stat="identity", aes(color=variable))+
  labs(title = "Taux de sexisme", x=NULL, y="Taux en %")+
  scale_colour_manual(values=c("Pink"," purple", "Darkgreen","Grey"))+
 scale_y_continuous(labels = scales::percent,limits=c(0,0.005))

ggsave("sex_ism01.svg",plot=last_plot(), width = 30, height = 20, units = "cm")


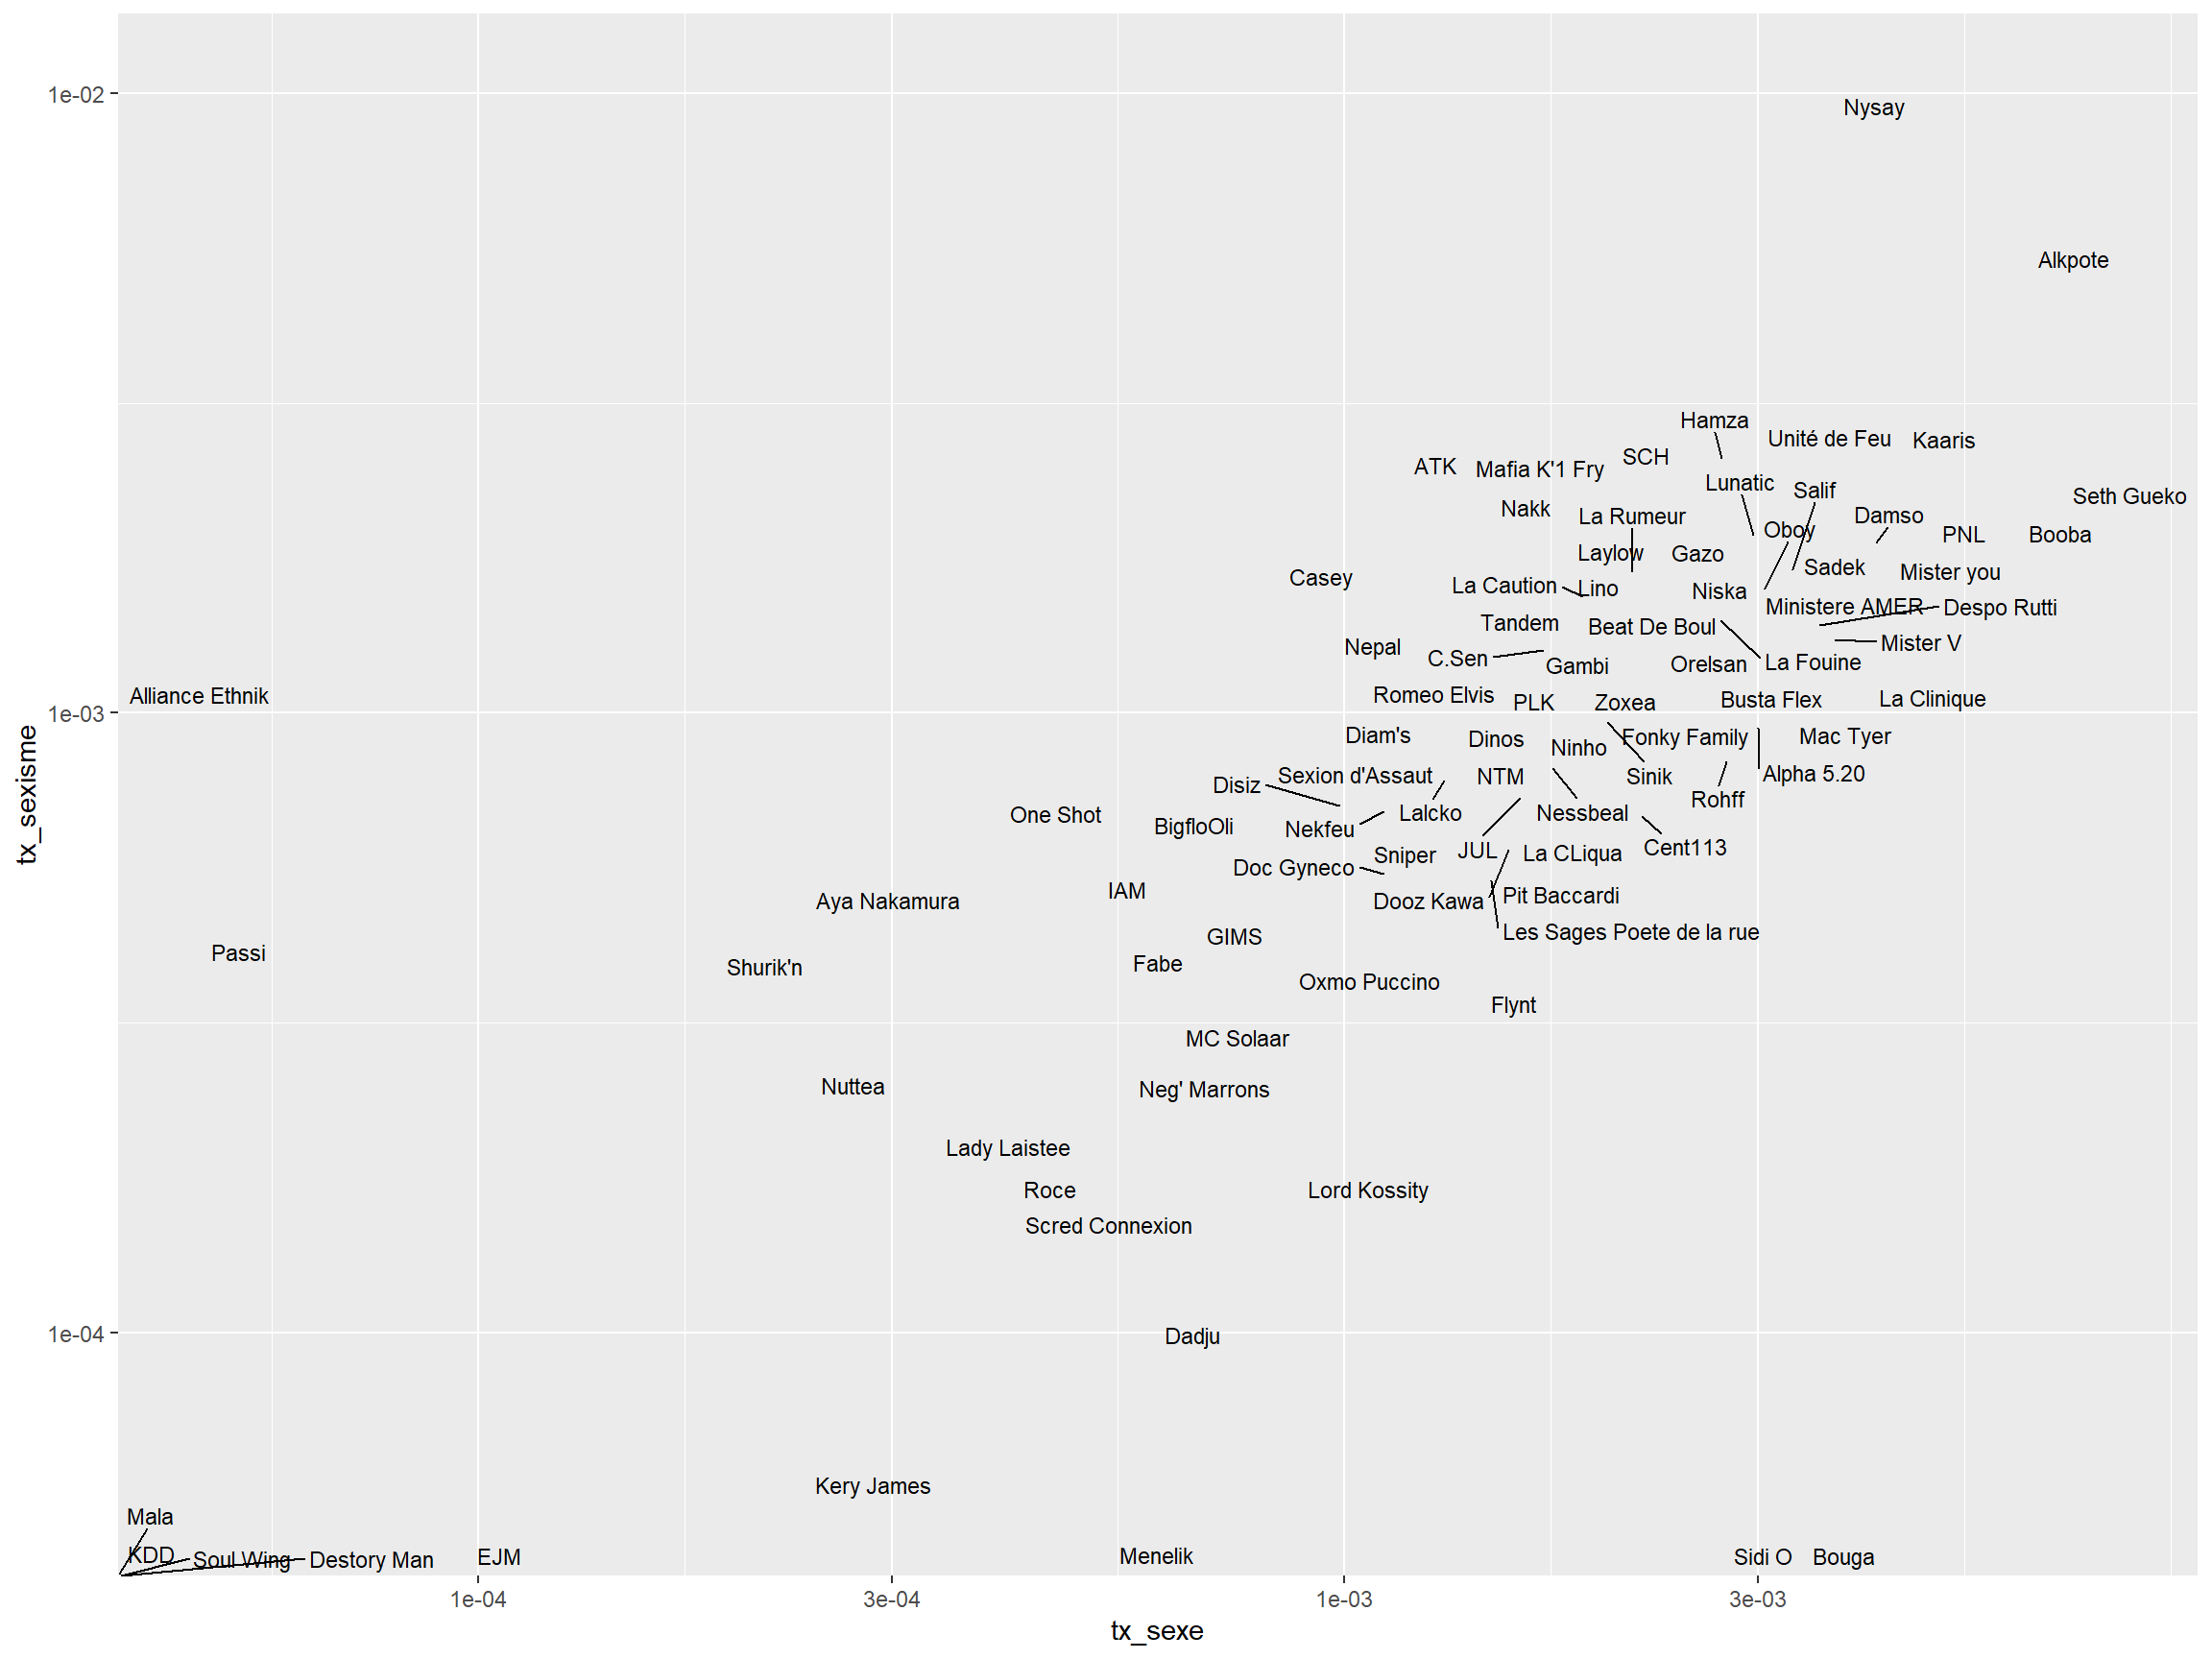
foo2<-foo %>%
  group_by(Artiste) %>%
  summarise(tx_sexisme=mean(tx_sexisme, na.rm=TRUE),
            tx_sexe=mean(tx_sexe, na.rm=TRUE))%>%
  pivot_longer(Artiste,names_to="variable", values_to='value')

ggplot(foo2,aes(x=tx_sexe, y=tx_sexisme, groupe=variable))+
  geom_text_repel(aes(label=value), size=3, max.overlaps = 30)+
  scale_x_log10()+
  scale_y_log10()

ggsave("sex_ism02.svg",plot=last_plot(), width = 30, height = 20, units = "cm")

Regardons les mots

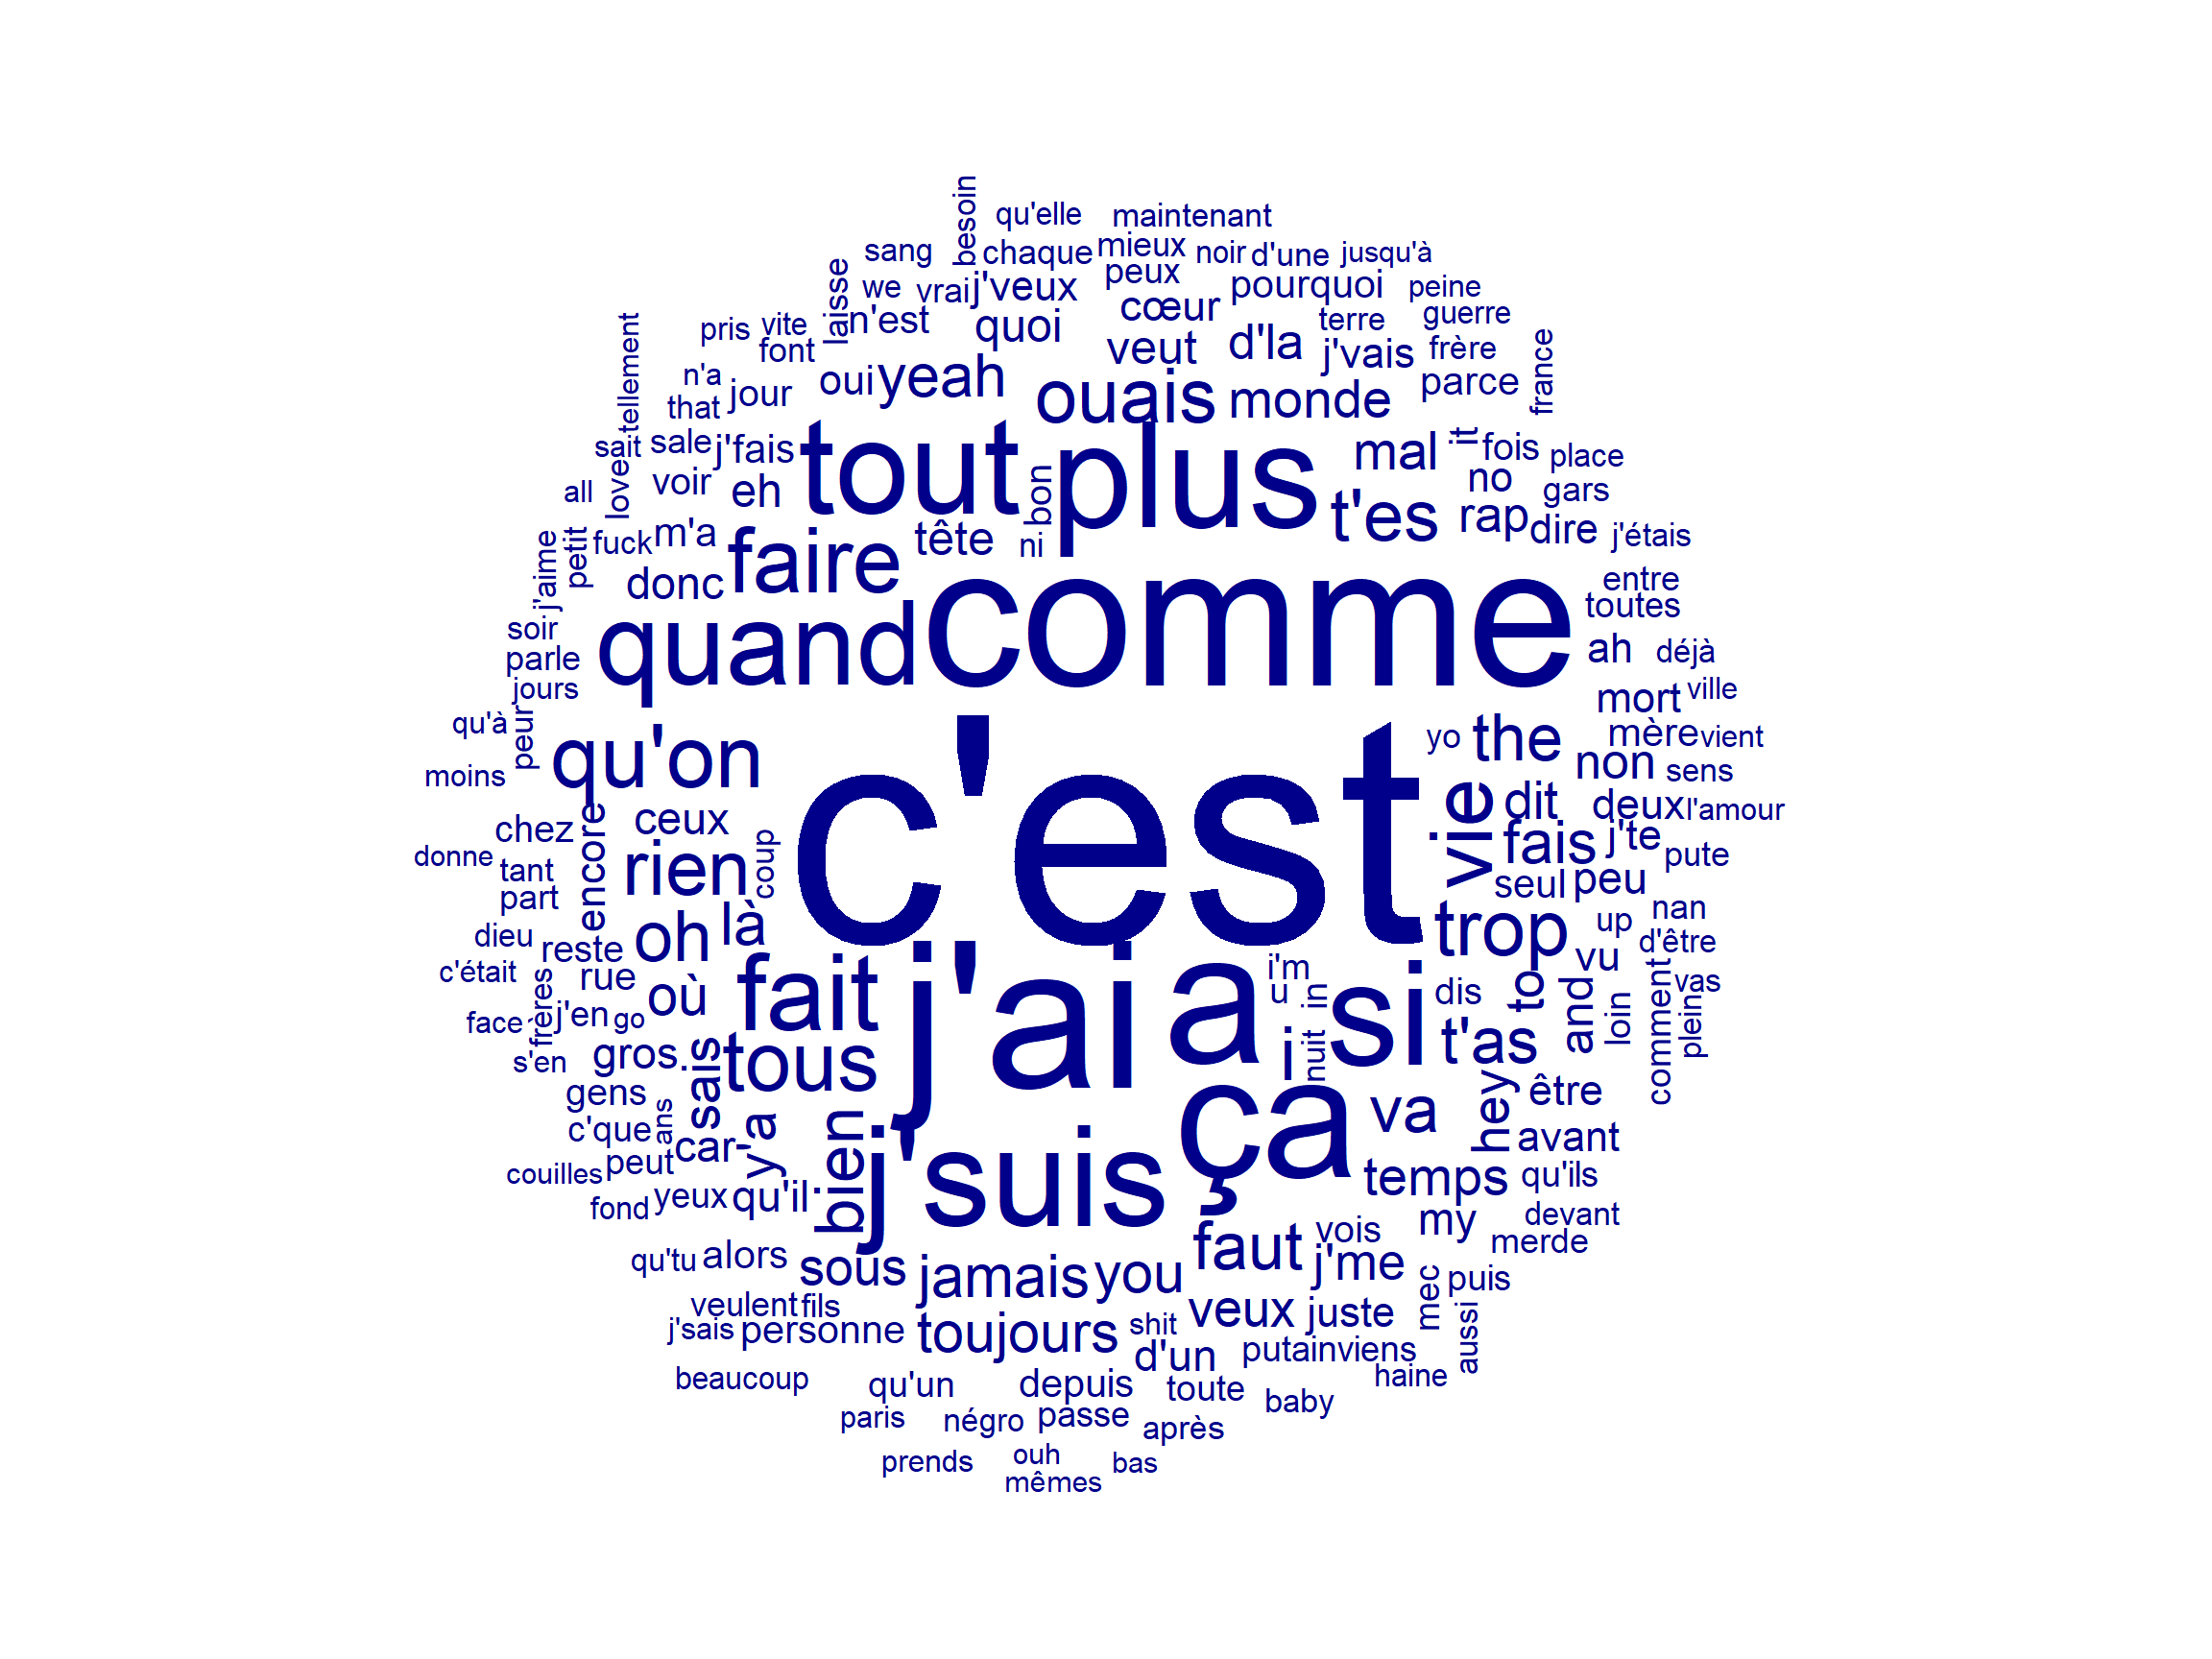
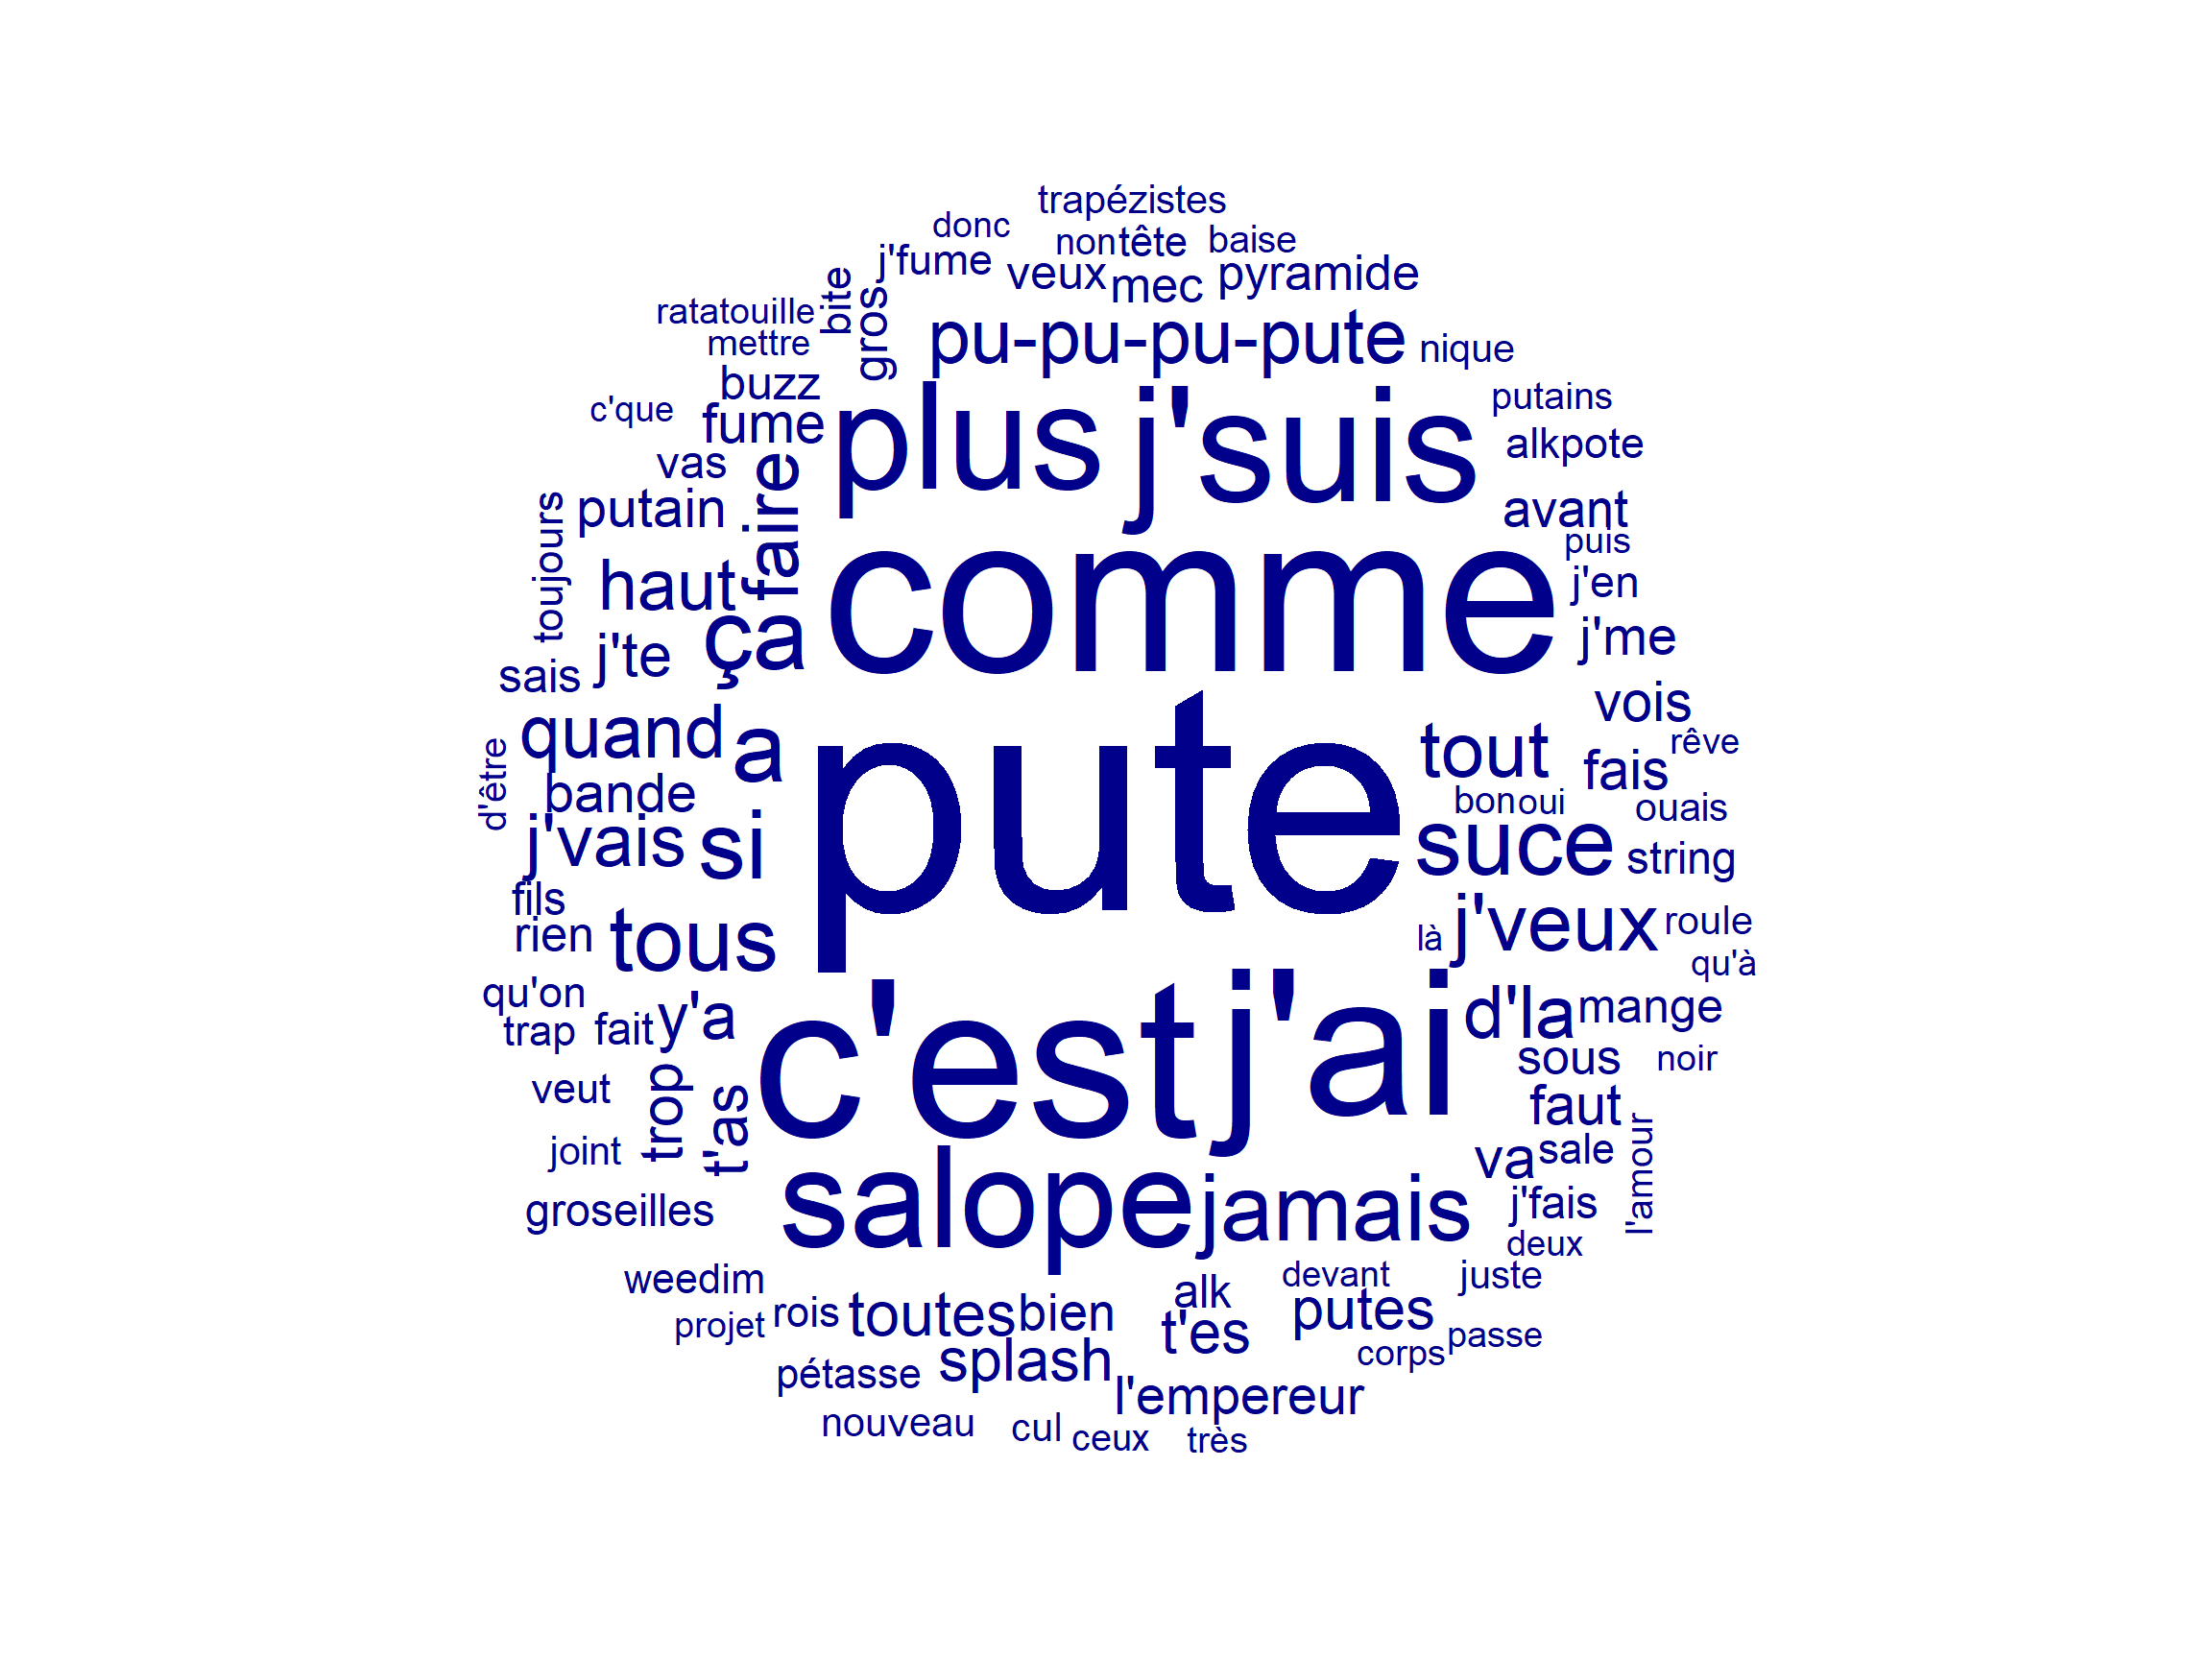
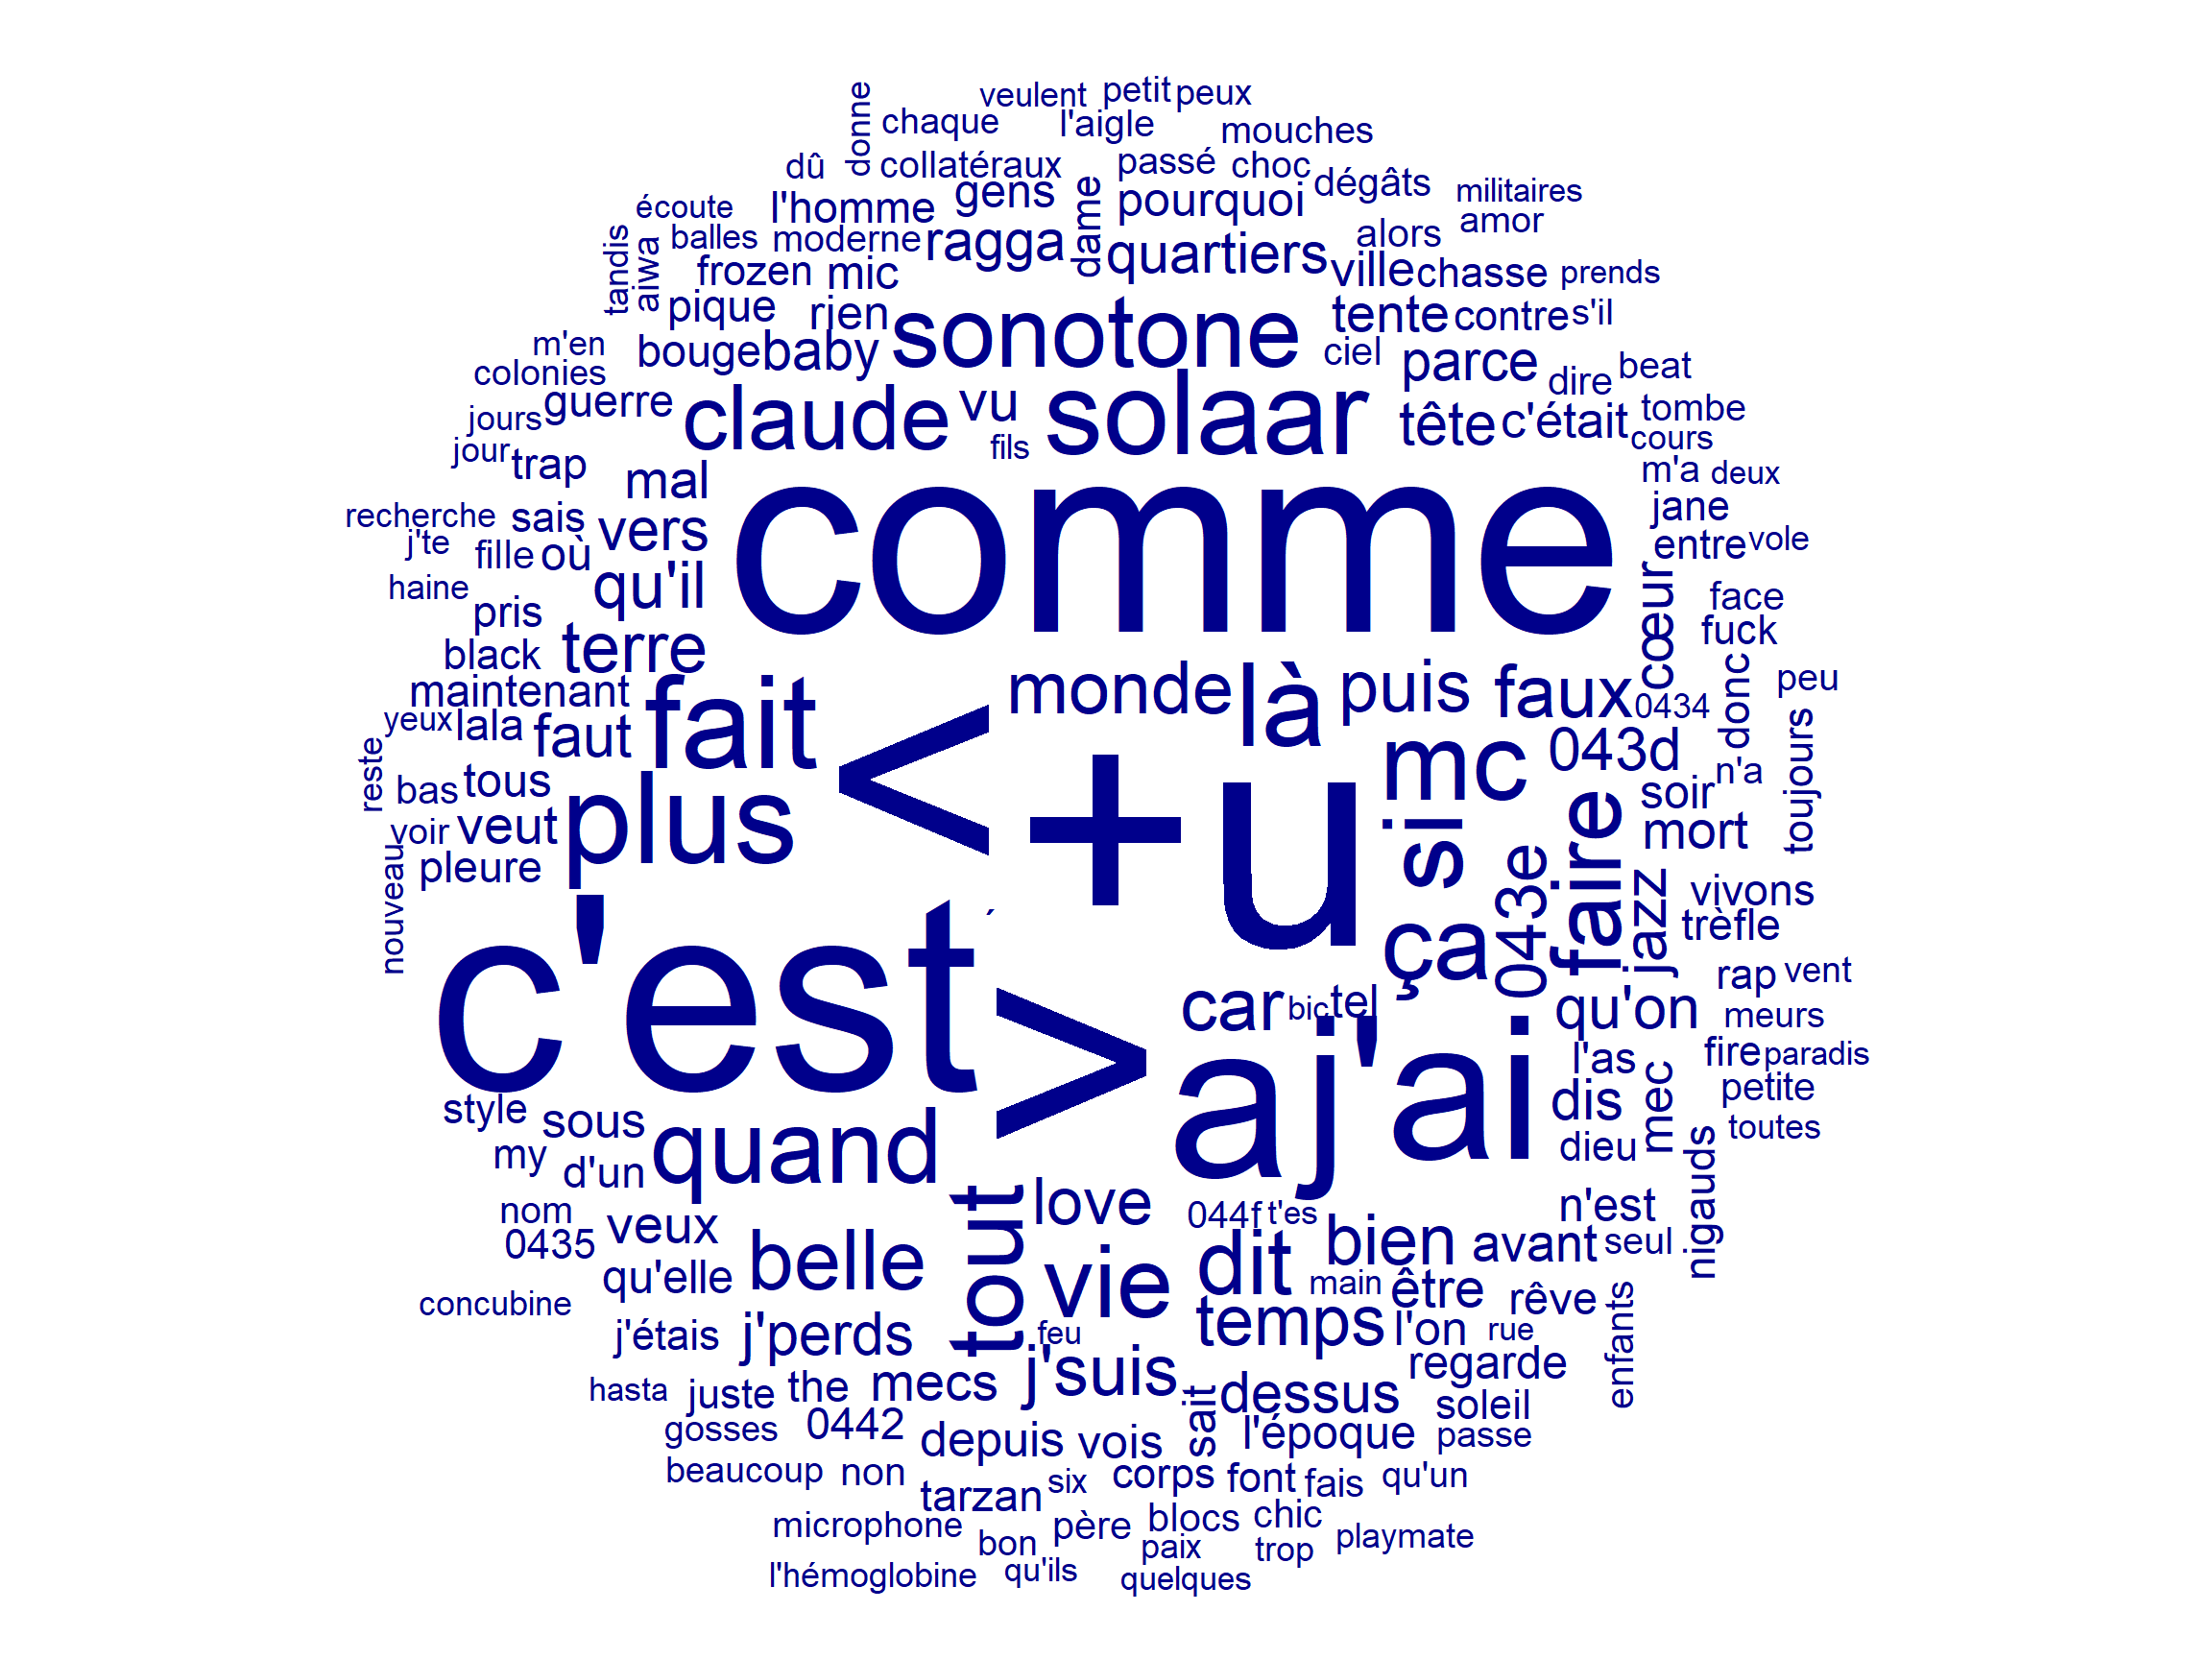
D’abord les compter, ensuite les représenter. Ce n’est qu’un avant-goût, la diversité est masquée par la généralité. On examinera aussi un cas particulier celui d’ Alkpote…. qu’il faudra comparer à MC solaar.
corpus<-corpus(text1,id_field = "Titre",text_field = "Paroles")

toks<-tokens(corpus,
            remove_punct = TRUE, 
            remove_symbols=TRUE, 
            remove_numbers=TRUE)%>%
  tokens_remove(stopwords("french"))%>%tokens_tolower()

foo1 <-unlist_tokens(toks) 

foo2<-foo1 %>% 
  group_by(token)%>%
  summarise(n=n())%>%
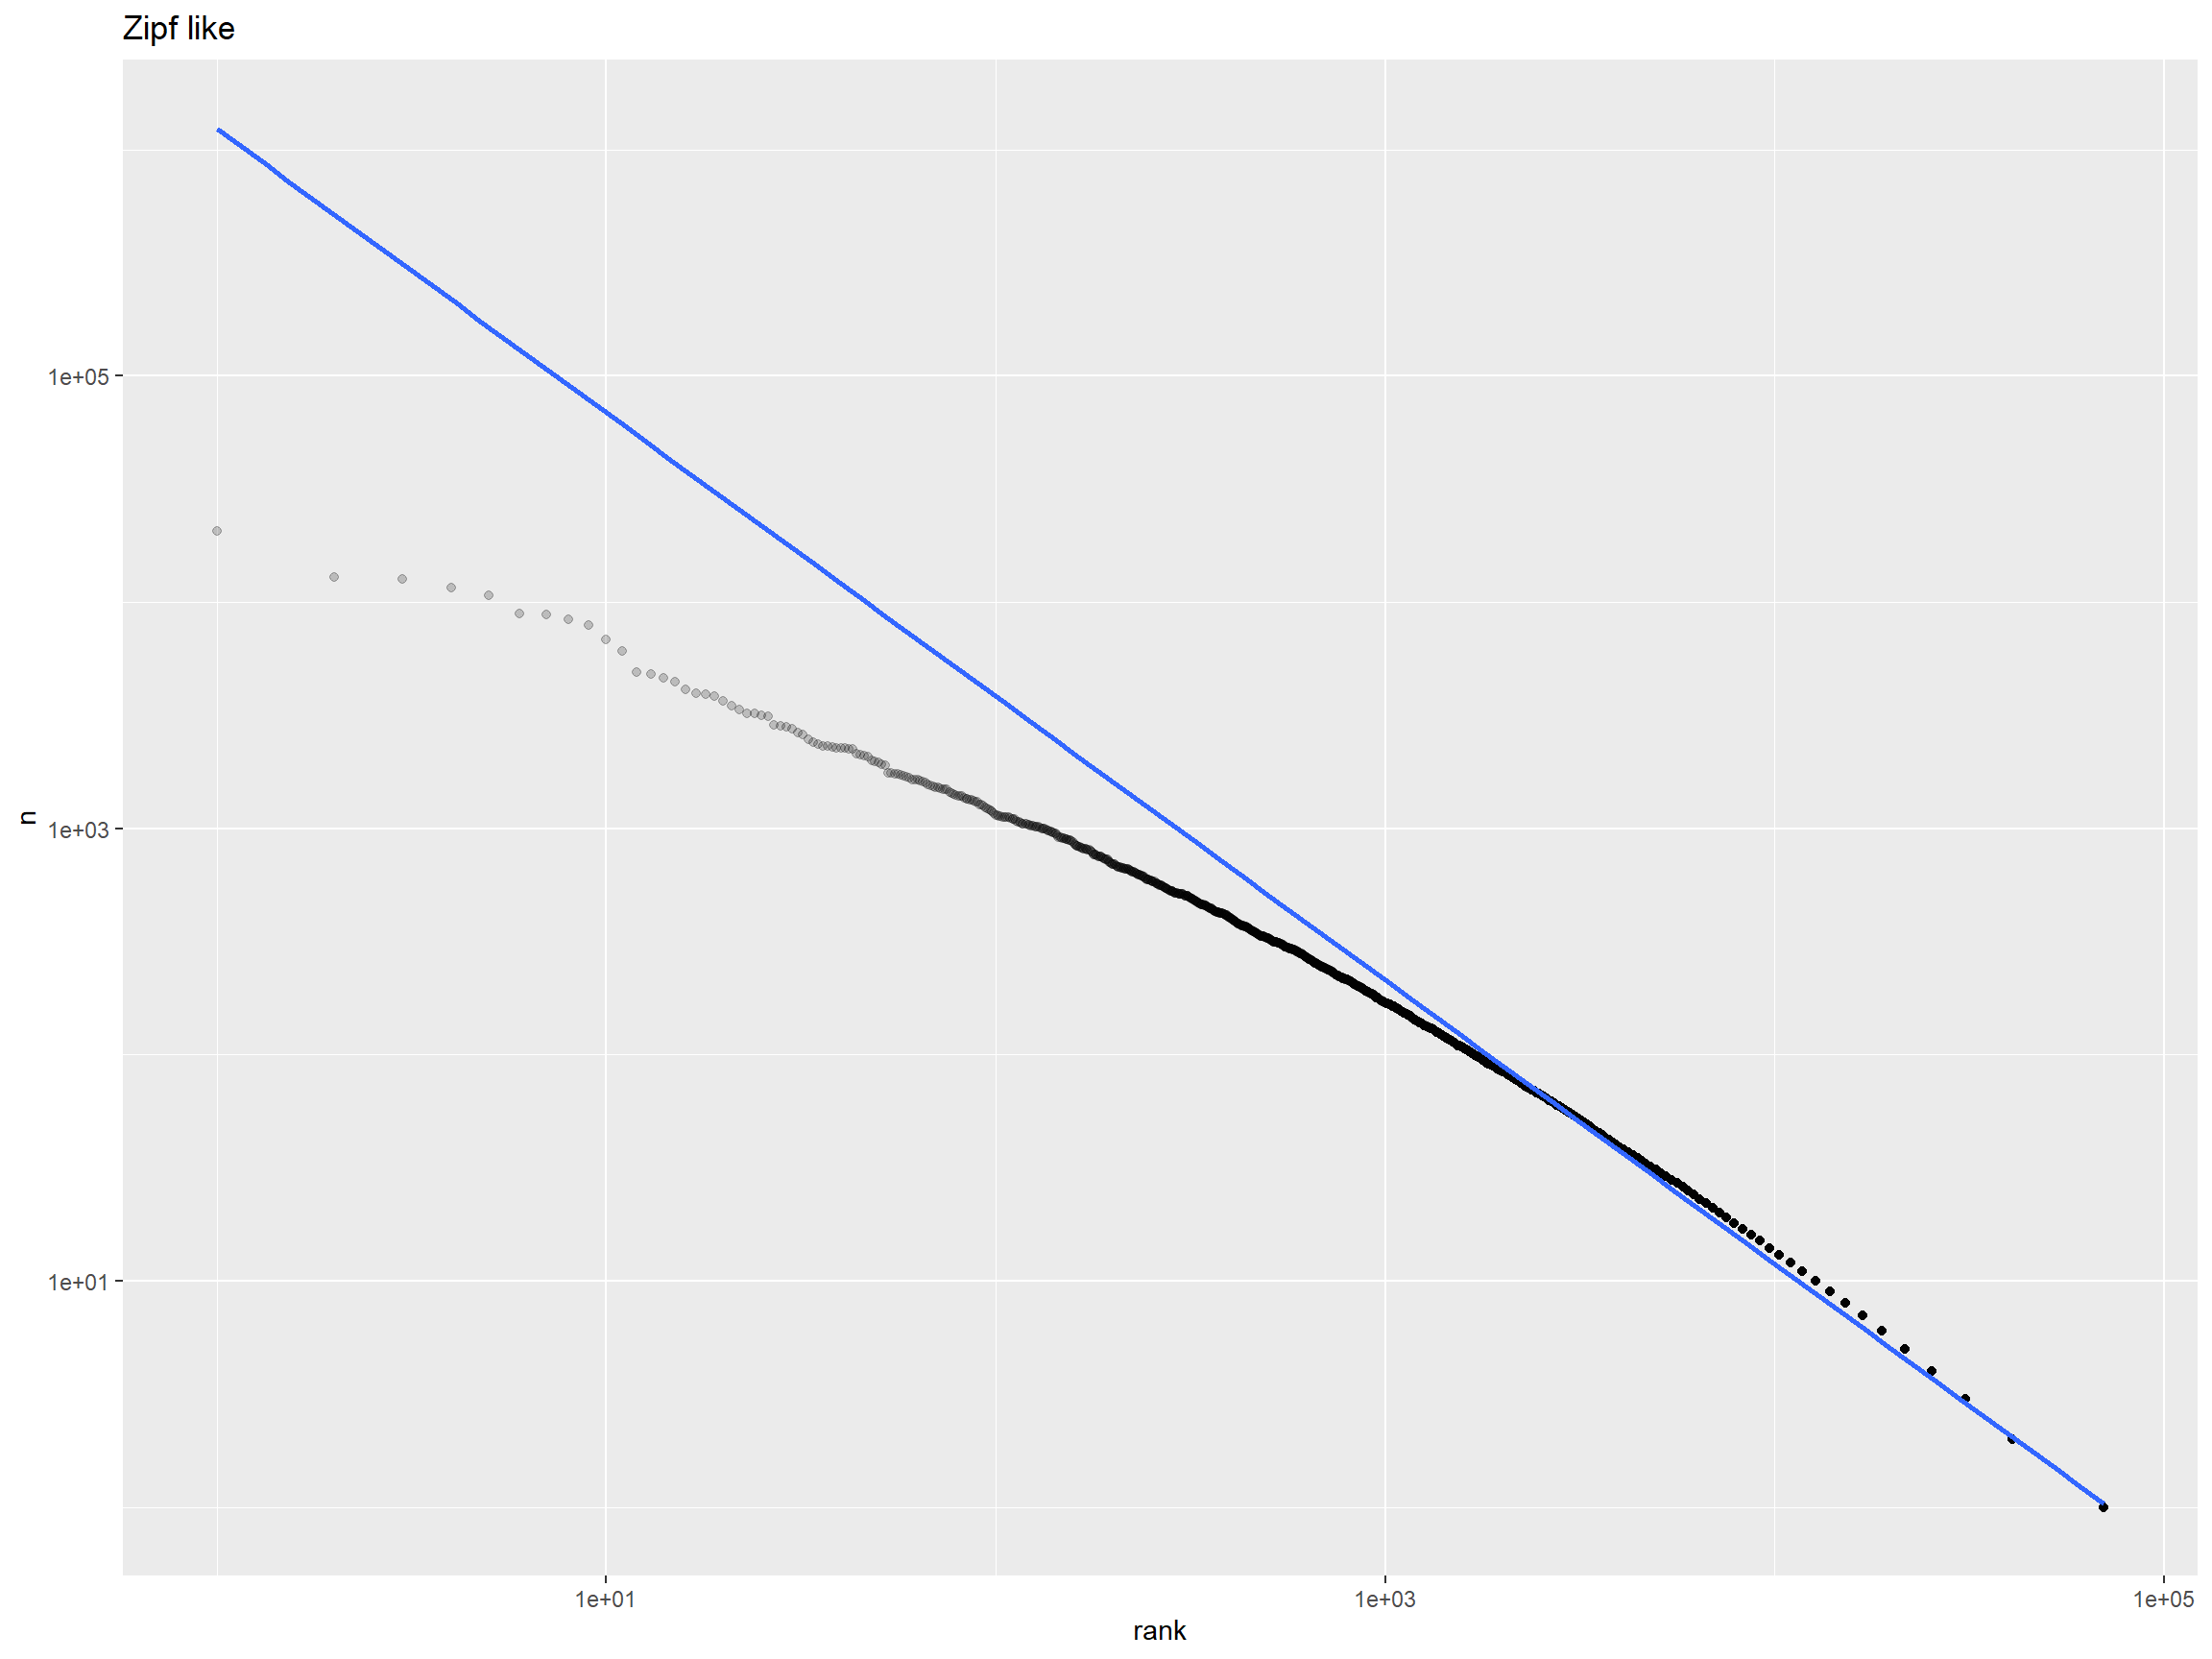
              mutate(rank=rank(desc(n)))
                     
ggplot(foo2, aes(x=rank,y=n))+
  geom_point(alpha=.2)+geom_smooth(method=lm)+
  scale_x_log10()+
  scale_y_log10()+
  labs(title = "Zipf like")

#with cleaning

dfmat1 <-toks %>% dfm()%>%
  dfm_trim(min_termfreq = 1)

textplot_wordcloud(dfmat1, max_words = 200,   max_size = 8)

#keyness

#le cas alkpote
dfmat2 <- dfm(corpus_subset(corpus, Artiste == "Alkpote"),
              remove = stopwords("french"), remove_punct = TRUE) %>%
   dfm_trim(min_termfreq = 3)

textplot_wordcloud(dfmat2, max_words = 100,max_size = 8)

#le cas Mcsolarr
dfmat2 <- dfm(corpus_subset(corpus, Artiste == "MC Solaar"),
              remove = stopwords("french"), remove_punct = TRUE) %>%
   dfm_trim(min_termfreq = 3)

textplot_wordcloud(dfmat2, max_words = 200,max_size = 8)