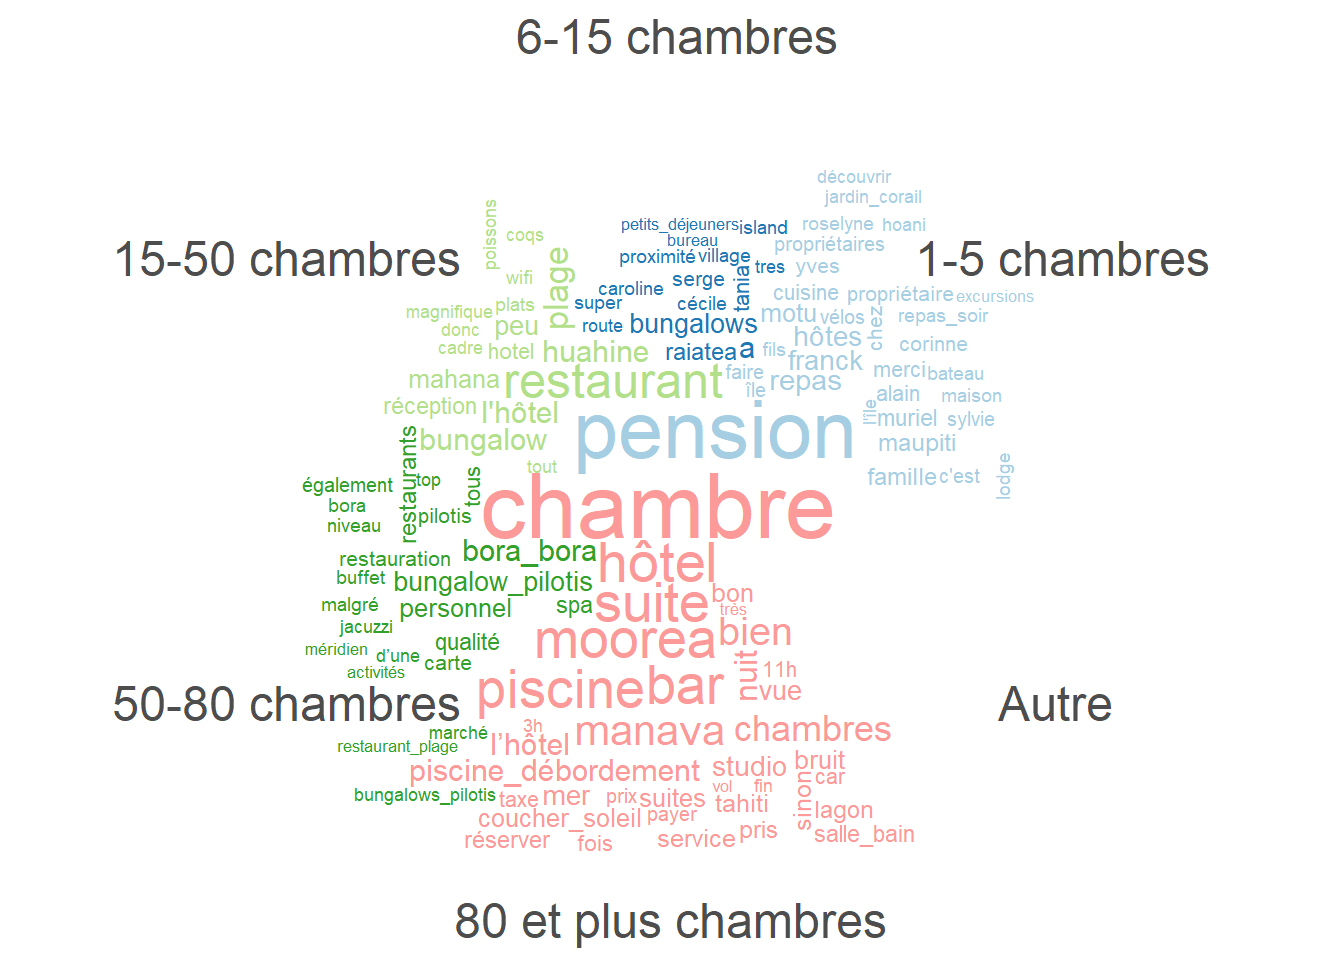
L’analyse du texte commence par découper les chaines de caractères en unités pertinentes, c’est souvent le mot, ce peut être la syllabe, la phrase, ou la lettre. Ces unités sont des jetons, les pièces élémentaire d’un traitement plus sophistiqué. cette opération permet de quantifier le texte et de le représenter sous la forme de dfm.
L’étape initiale de toute analyse textuelle est de découper le texte en unités d’analyse, les tokens, ou jetons en français, ce qui transforme le texte écrit pour la compréhension humaine en données interprétables par l’ordinateur. Les tokens utilisés peuvent varier selon les objectifs de l’analyse et la nature du corpus, la granularité peut être plus ou moins fine. Les tokens peuvent ainsi être :
des lettres : c’est l’unité insécable.
des syllabes : ça permet de s’intéresser aux phonèmes.mais aussi d’extraire d’un mot les suffixes et préfixes, ainsi que les radicaux ( la racine du mot, ex : dés-espéré-ment).
des mots : il s’agit du niveau le plus évident et le plus courant, que l’on privilégiera tout au long de ce livre, il présente aussi des difficultés car il ne coincide par avec l’unité de sens, par exemple avec les locutions: ” Président de la République”, ni avec les lexiques établis, ils peuvent prendre souvent la caractéristiques de mots fantômes
des phrases : c’est l’unité de langage, lui correspond un argument, une proposition ; l’usage du point suivi d’un espace et d’une majuscule est assez général pour les identifier.
des paragraphes : c’est une unité plus générale, qui souvent développe une idée.
des sections, des chapitres, ou des livres : selon la nature des documents, cela permet de découper le corpus en sous-unités.
Les tokenizers sont les outils indispensables à cette tâche. Dans cet ouvrage, nous nous concentrons sur l’étude des mots. Lors de cette étude, un certain nombre de mots apparaissent de nombreuses fois, pour permettre de donner du sens au langage humain, mais ils ne portent pas en eux d’informations particulièrement pertinentes pour l’analyse : ce sont les stopwords, qu’il conviendra souvent d’éliminer.
Les n-grammes, quant à eux, représentent des suites de n tokens. Un unigramme est donc équivalent à un token, un digramme1 est une suite de deux tokens, etc. L’identification des n-grammes permet de détecter des suites de tokens qui reviennent plus souvent que leur probabilité d’occurrences. Si l’on se concentre sur les mots, nous sommes alors face à une unité sémantique, comme on le comprend facilement avec le digramme ‘Assemblée Nationale’ dont le sens est plus que ses constituants.
Tokeniser revient donc à découper le texte pour en construire une représentation quantitative.C’est d’ailleurs une des spécificités des grands modèles de langage qui s’intréesse moins aux mots, qu’à ses décompositions, telles qu’un nombre limité( ~30 000) permette de générer la plupart des graphies et au passage de supporter les dysgraphies.
7.1 Quelques exercices de tokenization
7.1.1 Les lettres
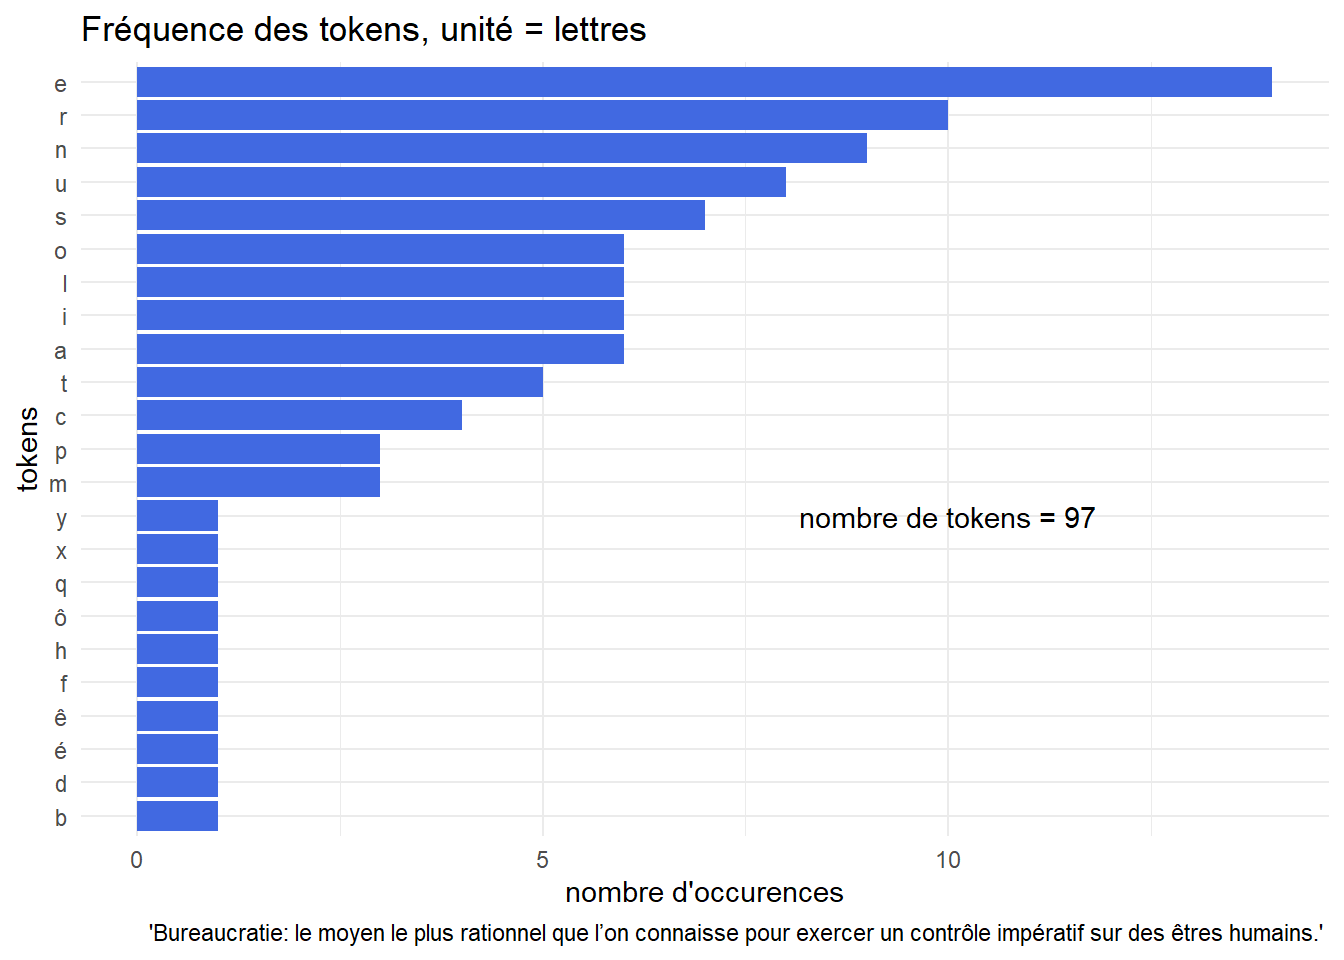
Commençons par un exemple simple, à l’aide d’une courte citation de Max Weber. On choisit les lettres pour unité de découpe, et l’on utilise le package ‘tokenizer’. Automatiquement, ‘tokenizer’ met le texte en minuscule et élimine la ponctuation
Show the code
#Les donnéesMaxWeber <-paste0("Bureaucratie: le moyen le plus rationnel que l’on connaisse pour exercer un contrôle impératif sur des êtres humains.")#On tokenise, plus on transforme en dataframe le résultat.toc_maxweber<-tokenize_characters(MaxWeber)%>%as.data.frame()%>%rename(tokens=1)#On compte pour chaque token sa fréquence d'apparitionfoo<-toc_maxweber %>%group_by(tokens)%>%summarise(n=n())%>%filter(n>0)#On représente par un diagramme en barre cette distribution des occuences d'apparition, en classant les tokens par fréquenceggplot(foo, aes(x=reorder(tokens,n), y=n))+geom_bar(stat="identity", fill="royalblue")+annotate("text", x=10,y=10, label=paste("nombre de tokens =", nrow(toc_maxweber)))+coord_flip()+labs(title ="Fréquence des tokens, unité = lettres", x="tokens", y="nombre d'occurences", caption =" 'Bureaucratie: le moyen le plus rationnel que l’on connaisse pour exercer un contrôle impératif sur des êtres humains.' ")
7.1.2 les mots
Show the code
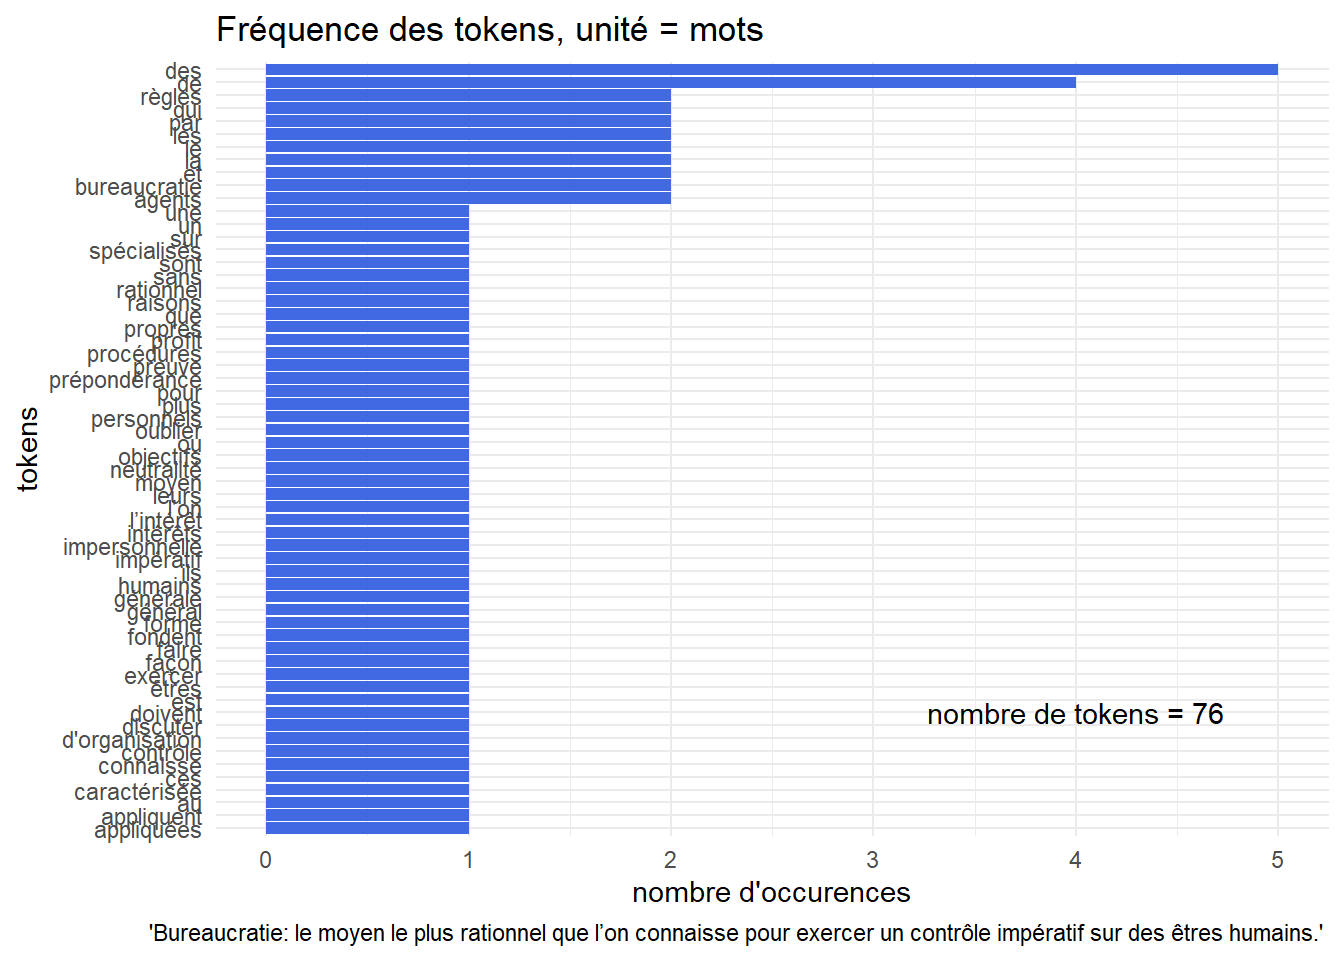
#Les donnéesMaxWeber <-paste0("Bureaucratie: le moyen le plus rationnel que l’on connaisse pour exercer un contrôle impératif sur des êtres humains. La bureaucratie est une forme d'organisation générale caractérisée par la prépondérance des règles et de procédures qui sont appliquées de façon impersonnelle par des agents spécialisés. Ces agents appliquent les règles sans discuter des objectifs ou des raisons qui les fondent. Ils doivent faire preuve de neutralité et oublier leurs propres intérêts personnels au profit de l’intérêt général.")#On tokenise, plus on transforme en dataframe le résultat. le strp_punc écarte la ponctuation du processus.toc_maxweber<-tokenize_words(MaxWeber,strip_punct=TRUE)%>%as.data.frame()%>%rename(tokens=1)#On compte pour chaque token sa fréquence d'apparitionfoo<-toc_maxweber %>%mutate(n=1) %>%group_by(tokens)%>%summarise(n=sum(n))#On représente par un diagramme en barre cette distribution des occurrences, en classant les tokens par fréquenceggplot(foo, aes(x=reorder(tokens,n), y=n))+geom_bar(stat="identity", fill="royalblue")+annotate("text", x=10,y=4, label=paste("nombre de tokens =", nrow(toc_maxweber)))+coord_flip()+labs(title ="Fréquence des tokens, unité = mots", x="tokens", y="nombre d'occurences", caption =" 'Bureaucratie: le moyen le plus rationnel que l’on connaisse pour exercer un contrôle impératif sur des êtres humains.' ")
On peut également constater que certains mots sont proches, par exemple les deux derniers sur le graphiques précédents qui sont des déclinaisons du verbe appliquer. Il peut alors être pertinent de regrouper ces différentes formes verbales (comme un mot au singulier et au pluriel, au féminin et au masculin, ou conjugué sous différentes formes), pour faciliter l’analyse. C’est ce qu’on fait avec les opérations de stemming ou de lemmatisation, présentées au chapitre 8.
7.1.3 Les phrases
On reproduit les mêmes opérations, mais cette fois sur les phrases de l’exemple précédent.
Bureaucratie: le moyen le plus rationnel que l’on connaisse pour exercer un contrôle impératif sur des êtres humains.
La bureaucratie est une forme d'organisation générale caractérisée par la prépondérance des règles et de procédures qui sont appliquées de façon impersonnelle par des agents spécialisés.
Ces agents appliquent les règles sans discuter des objectifs ou des raisons qui les fondent.
Ils doivent faire preuve de neutralité et oublier leurs propres intérêts personnels au profit de l’intérêt général.
7.2 N-grammes
Les n-grammes sont des séquences de n tokens, généralement consécutifs. Sur la d’un base d’un corpus important on peut calculer la probabilité d’apparition d’un n-gramme. C’est l’exercice auquel une équipe de google s’est attelé avec le Books Ngram Viewer. et dont nous encourageons l’étude détaillée.
L’article original doit aussi être lu. Sur la base de 5 millions de livres numérisés en 2011 et représentant 4% du nombre total de livres à jamais publiés à ce moment, être lu aussi, il montre que, pour l’anglais, chaque année 8500 mots entrent dans le lexique, sans que les dictionnaires, pour des raisons évidentes de concision, n’en font l’inventaire. Le webster comprend 300 000 mots, alors que pour l’anglais l’estimation du nombre de termes différents, est passé de l’ordre de 500 000 en 1900, à plus d’1.5 million en 2000. Il donne aussi une dimension au lexique : celle de sa densité. Dans un corpus, à un moment donné quelle est la probabilité d’observer un token donné (au plus simple un mot). Sur un corpus de 500 milliards de termes (pour toutes les langues traitées), un mot qui apparaît une fois sur 1000 ( 10^-3), apparaît 5 millions de fois, s’il apparaît une fois sur 1 million, il apparaît 5000 fois. L’échelle de mesure est ainsi la fréquence : 10-3, 10-5, 10-6 ….
La notion de ngram au-delà de son apparence de tautologie possède aussi un intérêt théorique majeure. Les ngram sont des chaines de markov. Intérêt théorique des n gram : ce sont des chaines de markov.
Pour comprendre l’importance de ce concept on peut considérer au moins 3 applications remarquables
Application à l’auto-complétion . Son efficacité dépend naturellement de la taille des données récoltées. On comprend que pour google il est aisé d’être précis dans l’estimation de ces probabilités!
Mais mieux encore, ces propriété markovienne ( probabilistique) permettent aussi la correction d’erreur avec l’algorithme de Viterbi https://fr.wikipedia.org/wiki/Algorithme_de_Viterbi
Le principe de ‘textcat’ est fondée sur ces n-grammes de lettre. Chaque langue se caractérise par une distribution particulière des n-grammes. Pour décider de l’appartenance d’un texte à une langue, si on dispose des profils de distribution, on compare la distribution des n-grammes du texte à ces références. On peut ainsi calculer une distance et attribuer le texte à la langue dont il est le plus proche.
7.2.1 Mise en oeuvre
Si la notion est simple, sa mise en oeuvre l’est presque autant. Nous l’illustrons avec une séries d’exemples et le package “tokenizer” qui a ici un avantage pédagogique. On étudiera plus loin les ressources de “quanteda”.
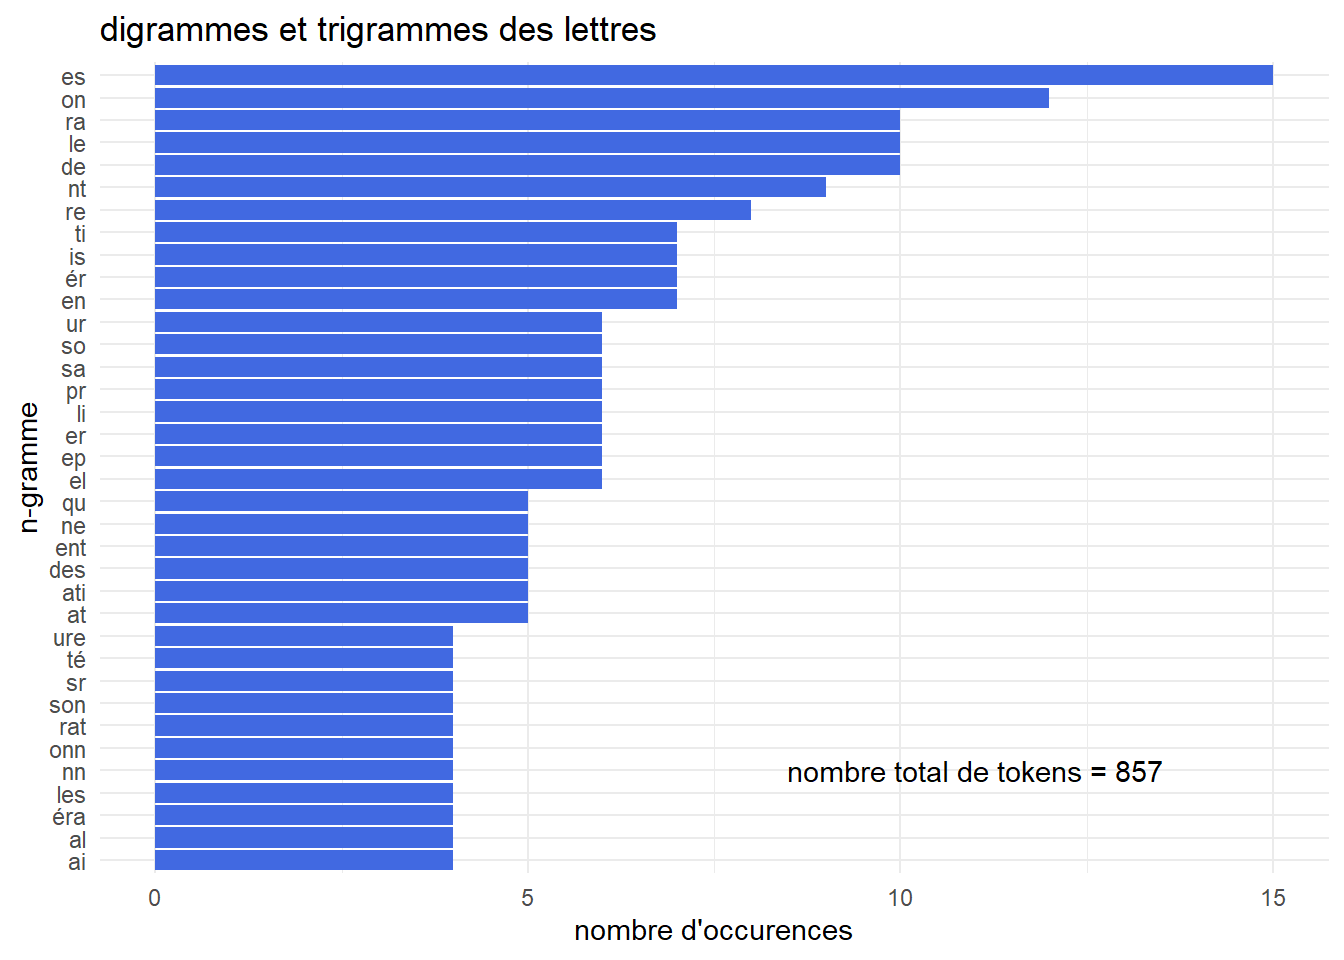
On commence de suite par un exemple sur les lettres. c’est de pure forme. On sélectionne les ngrammes (k>1 et k>4) dont la fréquence est supérieure à trois.
Show the code
#tokenization des lettrestoc_maxweber<-tokenize_character_shingles(MaxWeber,n=3, n_min=2) %>%as.data.frame()%>%rename(tokens=1)flextable(head(toc_maxweber, n=20))
tokens
bu
bur
ur
ure
re
rea
ea
eau
au
auc
uc
ucr
cr
cra
ra
rat
at
ati
ti
tie
Show the code
foo<-toc_maxweber %>%mutate(n=1) %>%group_by(tokens)%>%summarise(n=sum(n))%>%filter(n>3)ggplot(foo, aes(x=reorder(tokens,n), y=n))+geom_bar(stat="identity", fill="royalblue")+annotate("text", x=5,y=11, label=paste("nombre total de tokens =", nrow(toc_maxweber)))+coord_flip()+labs(title ="digrammes et trigrammes des lettres", x="n-gramme", y="nombre d'occurences")
On peut faire la même chose sur les mots, et en plus en éliminant les stopwords. l’intérêt de la procédure est de se concentrer sur les idées, des paires de mots consistants du point de vue sémantique. Un ordre ce dégage ! la bureaucratie est un moyen, puis une rationalité qui dépend d’un exercice.
On note qu’il n’y a pas besoin de beaucoup de mots pour produire du sens par l’analyse statistique de leurs distributions.
On peut également s’intéresser aux n-grammes non directement consécutifs mais séparés par k tokens. C’est sans doute un moyen de saisir des corrélations de mots à plus grande distance. La possibilité formelle est là , nous avouons ne pas savoir à quel usage elle correspond. Nous serions sur ce point ravi d’avoir des réponses.
Dans cet exemple, aucun n-gramme n’est répété, mais c’est rarement le cas avec des corpus plus importants. Dans ce cas, une forte répétition de n-grammes est un indice d’une unité sémantique composée de plusieurs tokens que l’on peut alors regrouper en un seul et même token. C’est ce que l’on verra dans la section suivante, avec la méthodes des collocation,
7.3 Choisir des n-grammes pertinents
Dans ce e-book l’unité principale d’analyse restera le mot. Mais nous savons, au moins intuitivement que certaines combinaisons de mots représentent des expressions qui ont la valeur d’un mot, une valeur sémantique, par exemple, l’expression “Assemblée Nationale”. Ces deux mots réunis constituent un syntagme, une unité de sens. La question qui se pose est alors de savoir comment les identifier dans le flot des n-grammes ?
La technique est simple : si deux mots se retrouvent dans un ordre donné plus fréquemment que ce que le produit de leurs probabilités d’apparition laisse espérer, c’est qu’ils constituent une expression. On peut imaginer faire un test du chi² pour décider si un couple de mots constitue une unité sémantique ou non.
Le package quanteda propose une bonne solution à ce problème avec la fonction collocation.
7.3.1 Créer les tokens avec ‘quanteda’
À partir du corpus des commentaires de TripAdvisor concernant les hôtels de Polynésie Française,
Show the code
#les donnéesAvisTripadvisor<-read_rds("./data/AvisTripadvisor.rds")AvisTripadvisor$Taille_hotel<-as.character(AvisTripadvisor$Taille_hotel)AvisTripadvisor$Taille_hotel[is.na(AvisTripadvisor$Taille_hotel)]<-"Autre"#création du corpuscorpus<-corpus(AvisTripadvisor,docid_field ="ID",text_field ="Commetaire", docvars =AvisTripadvisor)ft<-head(corpus,3) %>%as.data.frame()%>%rename(tokens=1)%>%flextable(cwidth =6)ft
corpus
tokens
Tout est magnifique au Vahine island. Séjour de rêve avec une équipe très chaleureuse . Le cadre est splendide. Notre meilleur hébergement en Polynésie.Merci à toute l' équipe pour votre gentillesse et vos nombreuses attentions.
Tout était parfait, notre meilleure expérience et plus belle découverte en Polynésie.Un grand merci à Amélie et toute son équipe pour un service de très haut niveau.De la chambre, en passant par la restauration et les activités, tout était parfait. Encore merci à tous, en espérant revenir très vite.
Un séjour magnifique, 3 jours époustouflants, accueillis chaleureusement par toute l’équipe du Vahine Island. Tout est au rendez vous, la cuisine délicieuse, le lieu au delà de notre imagination, un calme parfait. À faire, re faire, sans jamais s’en lasser.
On crée un objet de format token, avec la fonction tokens de quanteda, et on choisit d’enlèver la ponctuation, les symboles et les nombres avec les arguments correspondants.
Notre tokenizer ici a quelques problèmes . Si le “.” n’est pas suivi d’un espace, il ne peut distinguer les mots, il ne saisit pas non plus l’ellipse de “l’équipe”, qui devrait distinguer le determinant “la” de “équipe. Souvent il faudra au préalable remanier les chaines de caractère pour une meilleure qualité de tokenisation.
Show the code
#transformation en objet tokentok<-tokens(corpus,remove_punct =TRUE, remove_symbols=TRUE, remove_numbers=TRUE)head(tok,3)
Tokens consisting of 3 documents and 21 docvars.
1 :
 [1] "Tout"       "est"        "magnifique" "au"         "Vahine"
 [6] "island"     "Séjour"     "de"         "rêve"       "avec"
[11] "une"        "équipe"
[ ... and 22 more ]

2 :
 [1] "Tout"         "était"        "parfait"      "notre"        "meilleure"
 [6] "expérience"   "et"           "plus"         "belle"        "découverte"
[11] "en"           "Polynésie.Un"
[ ... and 37 more ]

3 :
 [1] "Un"              "séjour"          "magnifique"      "jours"
 [5] "époustouflants"  "accueillis"      "chaleureusement" "par"
 [9] "toute"           "l’équipe"        "du"              "Vahine"
[ ... and 27 more ]
Au passage, on peut aussi enlever les stopwords. C’est a dire les mots d’usages courants mais sans signification intrinsèque : les conjonctions, les déterminants, etc, qui se présentent sous la formes de dictionnaires.
Pour que les n-grammes très fréquents restent des syntagmes signifiants, on laisse apparentes les positions des stopwords, avec l’option padding= TRUE.
Show the code
#enlever les stopwordstok<-tokens_remove(tok,stopwords('fr'),padding=FALSE)head(tok, 3)
Tokens consisting of 3 documents and 21 docvars.
1 :
 [1] "Tout"        "magnifique"  "Vahine"      "island"      "Séjour"
 [6] "rêve"        "équipe"      "très"        "chaleureuse" "cadre"
[11] "splendide"   "meilleur"
[ ... and 7 more ]

2 :
 [1] "Tout"         "parfait"      "meilleure"    "expérience"   "plus"
 [6] "belle"        "découverte"   "Polynésie.Un" "grand"        "merci"
[11] "Amélie"       "toute"
[ ... and 18 more ]

3 :
 [1] "séjour"          "magnifique"      "jours"           "époustouflants"
 [5] "accueillis"      "chaleureusement" "toute"           "l’équipe"
 [9] "Vahine"          "Island"          "Tout"            "rendez"
[ ... and 13 more ]
7.3.2 Application à la détection des entités nommées
On cherche ici à identifier les noms propres présents dans le corpus.
Show the code
library(quanteda.textstats)#on sélectionne les mots commençant par une majusculetoks_cap <-tokens_select(tok, pattern ="^[A-Z]",valuetype ="regex",case_insensitive =FALSE, padding =TRUE)#on cherche les collocationststat_col_cap <-textstat_collocations(toks_cap, min_count =3, tolower =FALSE)flextable(head(as.data.frame(tstat_col_cap)))
collocation
count
count_nested
length
lambda
z
Bora Bora
155
0
2
6.604016
53.27337
Sylvie Yves
21
0
2
8.183783
25.93161
Muriel Franck
19
0
2
7.141592
24.46065
Corinne Frédéric
17
0
2
8.609701
23.23737
Pearl Beach
13
0
2
8.037935
21.75092
Yves Sylvie
13
0
2
7.285754
21.32976
7.3.3 Composer des tokens à partir d’expressions multi-mots : collocation
Dans ce corpus, les noms propres correspondent aux noms des îles et des hôtels, et aux prénoms composés. La valeur du lambda montre la force de l’association entre les mots, on retiendra d’une manière générale un lambda au moins supérieur à 3 pour remplacer les tokens d’origine par leurs n-grammes.
D’un point de vue pratique le nombre de colonne est de l’ordre de plusieurs milliers. Dans le cas de texte courts, quelques dizaines, ou même centaine de mots, moins de quelques pour-cent des lignes auront une valeur. C’est un tableau creux (sparse matrix) qui peut nécessiter des représentations particulières et plus économes.
Show the code
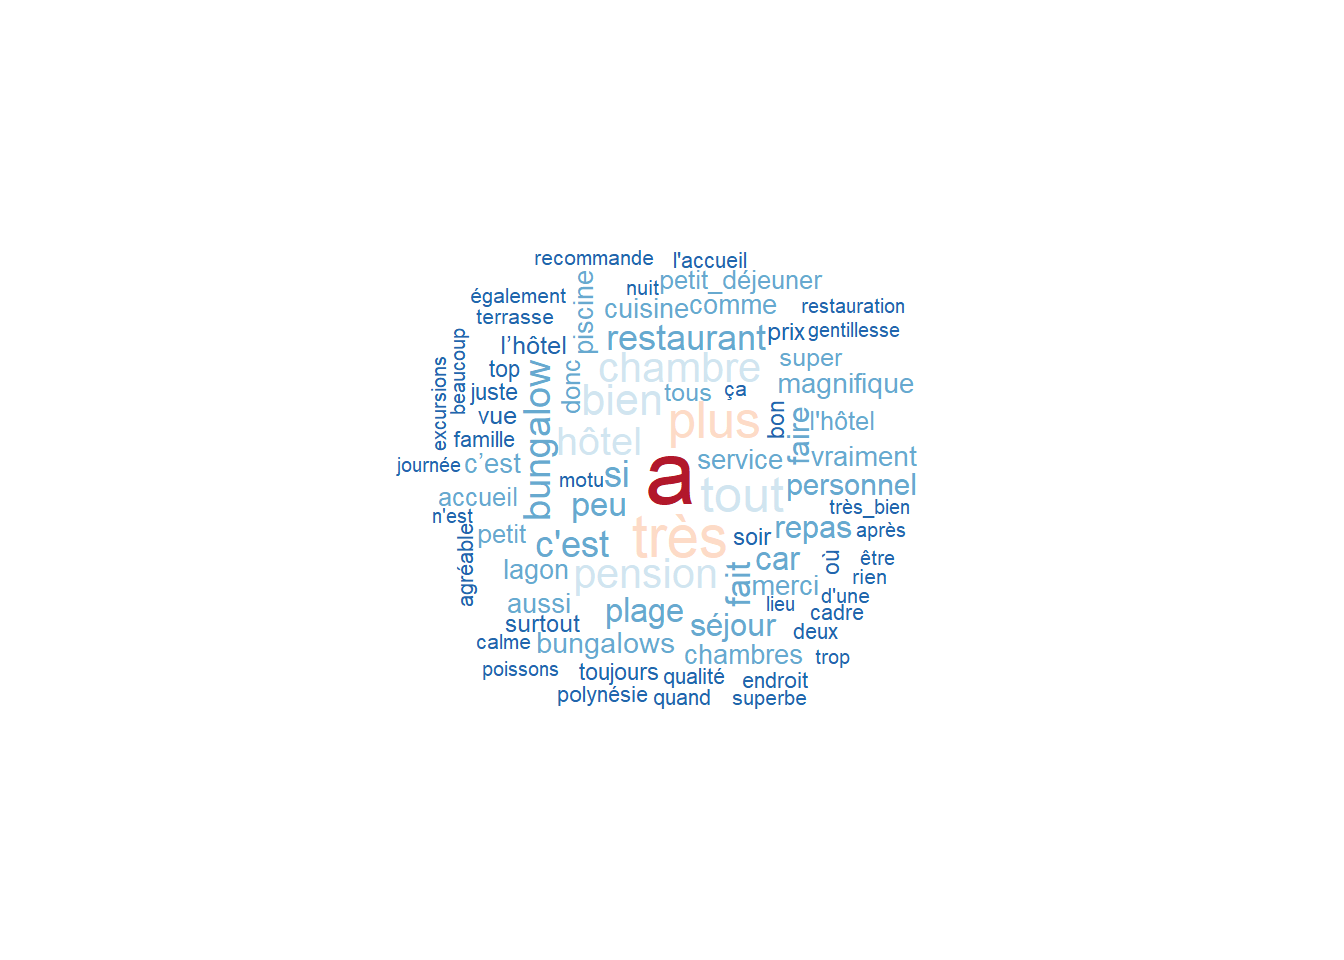
#on transforme en document-features matrix pour des représentations graphiques dfm<-dfm(toks_comp,remove_padding=TRUE) dfm <-dfm_remove(dfm, stopwords("fr"))dfm_top <-topfeatures(dfm, n =80, decreasing =TRUE, scheme ="count")dfm_top
             a           très           plus           tout           bien
          2345           1355           1194           1141            930
       pension        chambre          hôtel       bungalow             si
           896            883            804            775            748
         c'est     restaurant            peu          plage           fait
           740            716            702            670            663
           car          repas         séjour      personnel          faire
           623            606            600            577            551
     bungalows        service          merci       vraiment     magnifique
           527            480            479            475            472
         comme        piscine          lagon          aussi        cuisine
           469            469            467            463            453
      chambres          c’est           donc        accueil petit_déjeuner
           450            448            436            432            427
       l'hôtel          petit          super           tous            vue
           426            419            395            392            386
       l’hôtel           soir           prix        surtout          juste
           386            377            371            359            351
            où       toujours            bon            top        qualité
           348            348            346            343            315
         quand        endroit       agréable           deux      polynésie
           315            313            313            306            305
       famille          cadre      l'accueil       terrasse           nuit
           303            302            299            294            288
    recommande          d'une           rien          calme           motu
           284            284            281            279            276
     également        superbe             ça          n'est    gentillesse
           275            267            266            265            257
          lieu       poissons       beaucoup          après      très_bien
           257            254            254            253            248
          trop           être   restauration        journée          temps
           247            247            246            246            244
Show the code
#un nuage de mots rapide library(quanteda.textplots) textplot_wordcloud(dfm, max_word=80, color =rev(RColorBrewer::brewer.pal(6, "RdBu")))
Plus que comparer la fréquence des mots on peux souhaiter identifier ceux qui sont les plus discrimants, les plus distinctifs.
7.5.1 Keyness index
7.5.2 Find keywords based on the Textrank algorithm
Le Textrank est un algorithme implémenté dans le paquetage R textrank. Cet algorithme permet de résumer un texte et d’en extraire des mots-clés. Pour ce faire, il construit un réseau de mots en vérifiant si les mots se suivent. Sur ce réseau, l’algorithme “Google Pagerank” est appliqué pour extraire les mots pertinents, après quoi les mots pertinents qui se suivent sont combinés pour obtenir des mots-clés. Dans l’exemple ci-dessous, nous souhaitons trouver des mots-clés à l’aide de cet algorithme pour les noms ou les adjectifs qui se suivent. Le graphique ci-dessous montre que les mots-clés combinent les mots pour former des expressions à plusieurs mots.
7.5.3 Rake
L’algorithme de base suivant s’appelle RAKE, acronyme de Rapid Automatic Keyword Extraction (extraction automatique rapide de mots clés). Il recherche des mots-clés en examinant une séquence contiguë de mots qui ne contient pas de mots non pertinents. En d’autres termes, il
en calculant un score pour chaque mot faisant partie d’un mot-clé candidat. parmi les mots des mots-clés candidats, l’algorithme examine le nombre d’occurrences de chaque mot et le nombre de cooccurrences avec d’autres mots. Chaque mot obtient un score qui est le rapport entre le degré du mot (le nombre de fois qu’il cooccurre avec d’autres mots) et la fréquence du mot. un score RAKE pour le mot-clé candidat complet est calculé en additionnant les scores de chacun des mots qui définissent le mot-clé candidat.
7.6 Conclusion
Dans ce chapitre, nous avons vu comment découper un corpus en unités, les tokens. Nous avons abordé le sujet des n-grammes, et vu comment composer des tokens à partir de concepts multi-mots, identifiés par des n-grammes adjacents.
On conclue sur l’idée que la distribution des termes d’un texte doit se comprendre dans deux dimensions : la fréquence des termes parmi tous les termes, leur fréquence à travers les documents.
En français digramme est la meilleure traduction de bigram, une bigramme en français est un mot dont les lettres peuvent former deux autres mot.↩︎