Nous savons désormais manipuler les termes, il est temps de s’intéresser à leur dimension syntaxique et à examiner comment on peut les étiqueter pour ajouter de l’information au niveau de chacun des termes
L’unité du langage n’est pas le mot, le mot est une unité de lexique. L’unité du langage se forme dans la glue qui associe les mots, une chimie pour poursuivre la métaphore, dans la mesure où les règles de la chimie sont des règles d’association.
Les mots dans la phrases s’associent de manière analogue. Leur glue sont les règles de syntaxe qui répondent à deux pressions , celle d’une grammaire naturelle, stochastique surement, et d’une grammaire plus formelle et conventionnelle que les académies, les groupes de pression et les communicants.
Cependant, les linguistes ont établi des régularités de catégories syntaxiques. Notamment les Part of speech, en français les éléments de langages, des catégories qui s’avère universelles, même si pour décrire correctement les langues on a besoin de catégories plus spécifiques. Ces catégories sont les noms communs, les noms propres, les verbes, les adjectifs, les déterminants, les conjonctions, la ponctuation.
8.1 Le processus d’annotation
Pour aller au-delà de l’analyse du seul lexique et de l’analyse de la cooccurence des termes à travers les textes, comme le font les méthodes de typologie et d’analyse factorielle des correspondance depuis longtemps, il est nécessaire d’analyser le texte en tenant compte de ses propriétés syntaxiques. Depuis une dizaine d’années, des outils puissants, les annotateurs, sont proposés de manière accessible.
Les plus connus sont Spacy, Stanford NLP ou UDpipe avec r .Dans l’environnement r différentes ressources sont disponibles : Quanteda, clean_nlp, Udpipe, …
Ils sont disponibles désormais dans de nombreuses langues même si la richesse et la précision obtenues varient d’une langue à l’autre
Ils s’appuient sur des corpus plus ou moins étendus et spécialisés d’annotations manuelle : les Treebanks.
Ils réalisent souvent plusieurs tâches dont les principales sont les suivantes :
Tokeniser : découper la chaîne de caractère en unité d’analyse( lettre syllabe, mot …)
Lemmatiser : associer à la forme fléchie, le mot racine, celui des dictionnaires courants.
Selon leurs catégories les mots peuvent soutenir des flexions. Le pluriel ou le singulier, le féminin ou le masculin, les desinances, les conjugaisons. Il conviendra
c’est le fait de ne conserver que le radical des mots, pour regrouper sous le même radical toutes les variétés morphologique d’un même mot. Il suffit dont d’enlever les syllabes qui correspondent aux suffixes et aux flexions du mot (mode singulier ou pluriel, genre, desinences : conjugaison et déclinaison etc..). On parle aussi de racinisation.
Un lemme est un mot racine (ne pas confondre avec le radical), sans inflexions de genre, de mode, de conjugaison ou de déclinaison. C’est généralement celui qu’on trouve dans les dictionnaires. Il s’agit de ramener un terme, à sa forme la plus simple qui en français est l’infinitif/masculin-singulier).Du point de vue des graphèmes des mots sont des variétés. Dans la série ” j’ai aimé” , ” J’aime”, “j’aimerais” , il y a un verbe dont on observe différente variation, la racine de ces variation est le lemme “aimer”. c’est une convention grammaticale, celle de prendre pour racine la forme infinitive.
La lemmatisation est le processus qui vise à réduire les morphologie à leur racine. Non pas une forme primitive du mot mais une forme catégorique.le cas de Wordnet et l’invention des synsets synonymes, antonymes, hyponyne, hyperonymes….. https://cran.r-project.org/web/packages/wordnet/vignettes/wordnet.pdf
8.2 Part of speech (POS)
le role du stanford project
Dans une phrase les mots n’ont pas la même valeur. Certains sont des nombres propres, ils se réfèrent à ce que nous venons de voir, c’est à dire des entitées nommées, d’autres désignent des catégories d’objet. Ce sont les noms communs qui se rapportent à des catégories de choses. Un marteau - si j’en avais un - peut être n’importe quel marteau, la masse qui casse la pierre, ou ce petit marteau qui me permet d’enfoncer un clou dans le cadre du tableau.
Des typologies universelles ont été construites, elles recouvrent des typologies plus spécifiques à certaines langues. Les désinences du latin ont par exemple disparu du français. Cette forme est spécifiques au latin, on la retrouvera en allemand. La notion de morphosyntaxique désigne précisément que les variations de formes des mots dépendent d’une règle syntaxique. Prenons le verbe, et sa forme, “être”, dont la forme au passé simple est “était”. La forme des mots change, mais l’idée reste.
C’est à Lucien Tesnière que l’on doit l’idée de la grammaire de la dépendance qui est au cœur du NLP moderne. L’idée est de déterminer au niveau de la phrase les relations entre ses termes de manière hiérarchisée selon un principe de gouvernant à subordonné.
Verdelhan-Bourgade (2020) résume son analyse de manière précise et concise :
“Tous les mots n’ont pas le même statut. Les mots pleins, qui « expriment directement la pensée » (p. 59), relèvent de quatre catégories structurales : les substantifs (notés par O), les adjectifs (A), les verbes (I), les adverbes (E). Les mots dits vides (souvent désigné de manière pratique par les stopwords aujourd’hui) précisent le sens des autres, ou servent à marquer des relations.La connexion établit la relation entre mot régissant et mot subordonné. Lorsqu’ un régissant commande un subordonné, cela constitue un nœud, qui peut se faire à partir d’une des quatre espèces de mots pleins”.
Il en donne l’exemple suivant : « Très souvent mon vieil ami chante cette fort jolie chanson à ma fille » où l’on peut repérer:
un nœud verbal, central, qui commande des actants (ami, chanson, fille) et des circonstants (souvent). La valence est « le nombre de crochets par lesquels un verbe peut attraper des actants », à peu près équivalente à « voix ».
les nœud substantivaux (ami, chanson, fille), qui commandent des compléments (mon, vieil, cette, jolie, ma)
le nœud adjectival (jolie) qui commande ici le subordonné ‘fort’
le nœud adverbial, très’ étant subordonné à ‘souvent’. ”
8.3.1 Arbre syntaxique
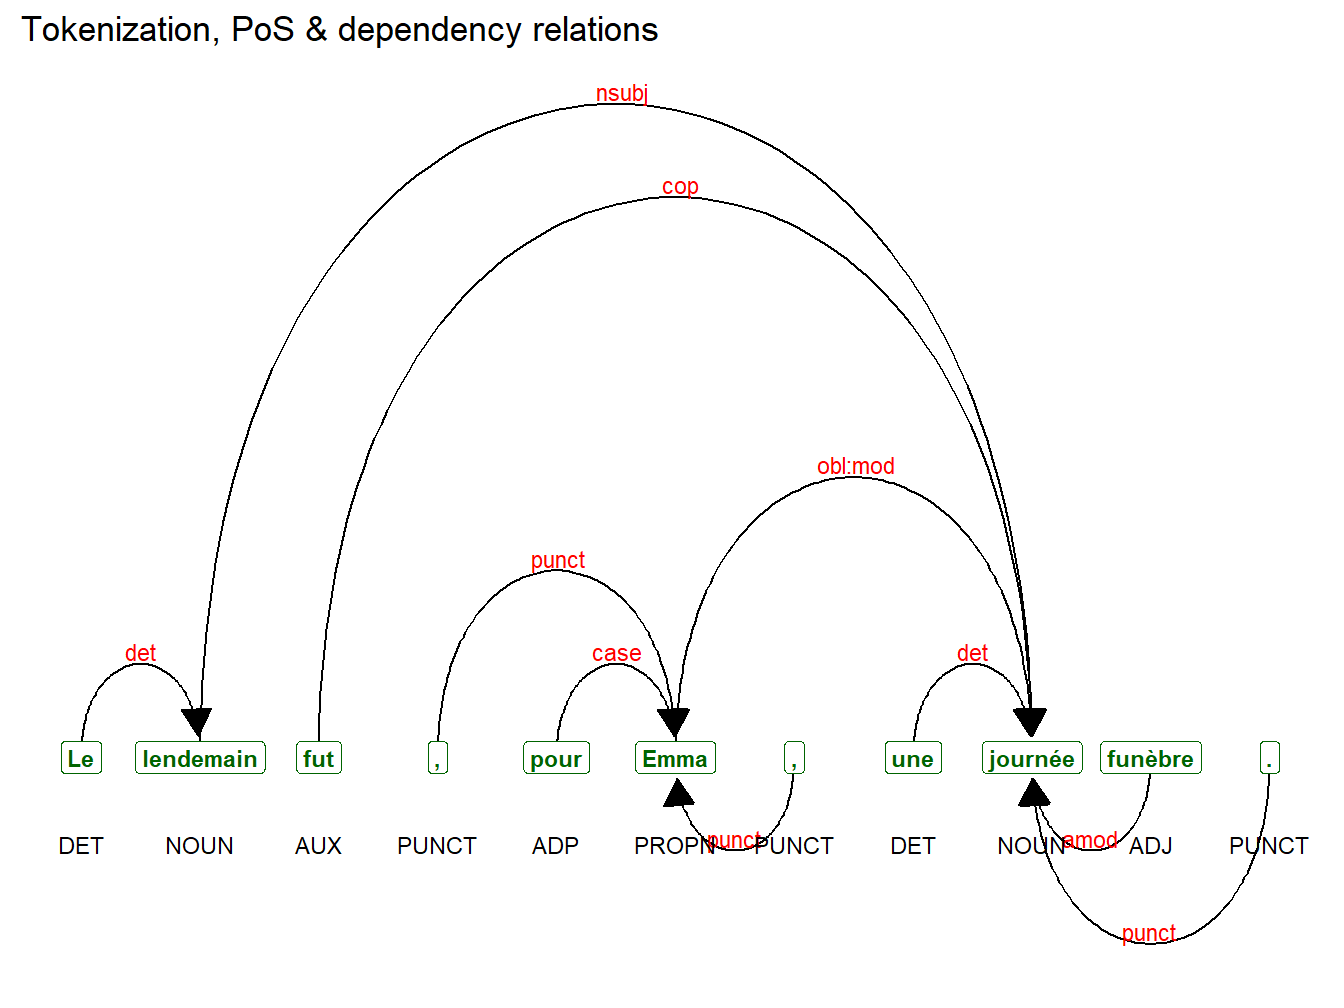
L’arbre syntaxique est obtenu en analysant les relations entre les termes. Nous poursuivons avec UDpipe, l’annotation précédente a déjà fait le travail. A chaque mot deux informations sont associées : la première est l’index du mot auxquel il se rapporte, la seconde est la nature de la relation.
On utilise ici une fonction écrite par [bnosac](http://www.bnosac.be/index.php/blog/93-dependency-parsing-with-udpipe) pour donner une représentation graphique de l’arbre.
En français courant les entités nommées correspondent largement à l’idée de noms propres. Un nom propre à une entité. Une chose qui est est indépendamment des catégories qui peuvent l’étiqueter. John Dupont, né le 19 février 1898 à Glasgow et abattu à Verdun le 8 août 1917, est un personnage unique. John Dupont ne désigne par une catégorie, mais bien une personne singulière. La désignation peut cependant être ambiguë, il y a un “Paris, Texas.”, et un Paris sur Seine. La morphologie ne résout pas l’ambiguïté.
les entités nommées appartiennent à différentes catégories d’objets : des noms de lieux, des noms de personnes, des noms de marques, des acronymes d’organisation,
Elles ne représentent jamais une catégorie mais une unité singulière.
En linguistique, la co-référence est le phénomène qui consiste pour plusieurs SyntagmeGroupe de morphèmes ou de mots qui se suivent avec un sens déterminé (ex. relire, sans s’arrêter).s nominaux (SN) différents contenus dans une phrase ou dans un discours, à désigner la même entité. Par exemple une personne, un lieu, un évènement, ou encore une date. Dans la terminologie linguistique, on dit qu’une co-référence est reliée à son antécédent. Pour que les syntagmes se co-réfèrent, les deux expressions doivent porter les mêmes traits : ils doivent être en accord en genre, en nombre et en personne.
C’est une tâche difficile, les ressources en français semble inexistante dans l’univers r. Une piste en anglais
8.6 Conclusion
La performance des annotateurs. Toute la qualité de l’analyse dépend de la qualité des annotateurs ? celle ci est généralement bonne au delà des 95%, mais peut ne pas résister avec certains corpus, Par exemple quand la ponctuation est absente. Dans ces cas il faut utiliser d’autres outils qui calculent les ponctuations.
C’est cependant un outil essentiel qui permet de se concentrer sur des cibles particulières : ce dont on parle, comment on le qualifie, quelles sont les actions engagées. Il permet d’entrer plus profondément dans la texture du texte.
8.7 Références
Verdelhan-Bourgade, M. 2020. “Lucien Tesnière, Professeur de Linguistique à Montpellier de 1937 à 1954. L’aventure d’une Grammaire.”Bulletin de l’Academie Des Sciences Et Lettres de Montpellier 51 (4562).